
Outras Especialidades › Epidemiologia e bioestatística
Sensibilidade, especificidade e valores preditivos
Sensibilidade, especificidade, valores preditivos e curva ROC
Tabela 2×2, desempenho diagnóstico e efeito da prevalência
Responda antes de ler
Escolha uma alternativa agora, mesmo sem certeza. Errar aqui faz parte — é o que faz a resposta certa grudar depois.
Em uma campanha de rastreamento, um novo teste para determinada doença é aplicado em 1.000 pessoas. A prevalência real da doença nessa população é de 100 casos. O teste identificou corretamente 90 dos 100 doentes como positivos e classificou corretamente 810 dos 900 não doentes como negativos. Com base nesses dados, qual é, aproximadamente, o valor preditivo positivo (VPP) do teste nessa população?
Como esse tema cai
Este capítulo não tem diretriz para decorar. Sensibilidade, especificidade, valor preditivo e área sob a curva são definições matemáticas: nenhuma sociedade médica as revisa, nenhuma versão nova sai no ano que vem. O que a prova cobra é se você sabe montar uma tabela de quatro casas e escolher o denominador certo — e, sobretudo, se você sabe o que acontece com cada medida quando a prevalência da doença muda.
Esse é o movimento único que aparece na maioria absoluta das questões do tema, em todas as bancas: pegam um teste com sensibilidade e especificidade fixas, mudam o cenário — do ambulatório de referência para o rastreamento populacional, do pronto-socorro para a unidade básica — e perguntam o que aconteceu. Quem entendeu que sensibilidade e especificidade vivem dentro das colunas da tabela, e que os valores preditivos vivem dentro das linhas, responde sem calculadora. Quem decorou as fórmulas soltas erra por denominador trocado.
As fontes brasileiras existem e são boas. O Ministério da Saúde publicou, pelo rebrats, uma diretriz metodológica inteira sobre estudos de acurácia diagnóstica, com a tabela 2×2, todas as fórmulas e dois exemplos numéricos resolvidos que demonstram o efeito da prevalência. A Sociedade Brasileira de Pneumologia e Tisiologia publicou uma série curta de educação continuada sobre o mesmo tema. Todo número deste capítulo vem de lá ou de material didático de instituição pública brasileira, e todo cálculo está feito passo a passo — a ideia é que você refaça cada um no rascunho da prova, sem calculadora.
O que muda decisão
A tabela 2×2: quem manda nas colunas é o padrão de referência
Todo o tema cabe numa tabela de quatro casas. A convenção da diretriz metodológica do Ministério da Saúde é a que as bancas usam: nas colunas vai a verdade — doença presente (+) ou ausente (−) —, definida pelo padrão de referência, que é o melhor teste disponível e é assumido como quem estabelece a verdadeira presença ou ausência da doença. Nas linhas vai o teste índice, aquele que está sendo avaliado: positivo, quando o valor fica acima do ponto de corte, ou negativo, quando fica abaixo.
Os quatro quadrantes recebem letras. A célula a é o verdadeiro-positivo: teste positivo em quem tem a doença. A célula b é o falso-positivo: teste positivo em quem não tem. A célula c é o falso-negativo: teste negativo em quem tem a doença. A célula d é o verdadeiro-negativo: teste negativo em quem não tem. Somando pelas colunas você obtém o total de doentes (a+c) e o total de não-doentes (b+d). Somando pelas linhas você obtém o total de testes positivos (a+b) e o total de testes negativos (c+d). O total geral é N = a+b+c+d.
Aí está o capítulo inteiro, e vale gastar dez segundos com isso antes de qualquer conta. Medida que divide pelo total de uma coluna condiciona à doença: é sensibilidade ou especificidade, e responde 'dado que a pessoa tem (ou não tem) a doença, o que o teste faz?'. Medida que divide pelo total de uma linha condiciona ao resultado do teste: é valor preditivo, e responde 'dado que o teste deu este resultado, o que a pessoa tem?'. Quem erra este tema quase sempre erra exatamente aqui: acerta o numerador e divide pelo denominador da direção errada.
Uma advertência de leitura: nem toda prova desenha a tabela com a doença nas colunas — algumas invertem, e algumas nem desenham tabela nenhuma, entregando só percentuais no texto. Não decore posição; decore denominador. Sensibilidade sempre divide pelo número de doentes. Especificidade sempre divide pelo número de não-doentes. Valor preditivo positivo sempre divide pelo número de testes positivos. Valor preditivo negativo sempre divide pelo número de testes negativos. Se você monta a tabela lendo os denominadores, a orientação escolhida pelo enunciado deixa de importar.
Sensibilidade e especificidade: as medidas que a prevalência não move
A sensibilidade é a probabilidade condicional de o teste ser positivo dado que a doença está, de fato, presente. Em letras: sensibilidade = a/(a+c). A especificidade é a probabilidade condicional de o teste ser negativo dado que a doença está, de fato, ausente: especificidade = d/(b+d). São medidas condicionadas ao estado de doença — cada uma calculada dentro de uma coluna só.
Um cálculo com os números do próprio documento oficial. No primeiro exemplo da diretriz do Ministério da Saúde, a tabela tem a = 81, b = 591, c = 45 e d = 674, num total de 1.391 pessoas. A coluna dos doentes soma 81 + 45 = 126; a dos não-doentes, 591 + 674 = 1.265. Sensibilidade = 81/126 = 0,64: na amostra, 64% dos pacientes que têm a doença foram corretamente identificados pelo teste índice. Especificidade = 674/1.265 = 0,53: 53% dos que não têm a doença foram corretamente liberados. Repare que o cálculo nunca cruzou de uma coluna para a outra.
Cada uma serve a um resultado. Sensibilidade alta significa poucos falsos-negativos — logo, um resultado negativo de um teste muito sensível afasta bem a doença. Especificidade alta significa poucos falsos-positivos — logo, um resultado positivo de um teste muito específico confirma bem. É a ponta que costuma ser trocada nas alternativas: 'teste altamente sensível, portanto o positivo confirma o diagnóstico' está errado; o que o teste sensível faz bem é descartar quando dá negativo.
O ponto que decide a maioria das questões: sensibilidade e especificidade não são afetadas pela prevalência da doença. A razão é aritmética e não exige fé. Se a prevalência cai, a coluna dos doentes encolhe — mas encolhem juntos o numerador (verdadeiros-positivos) e o denominador (todos os doentes), e a proporção fica onde estava. Mudar a prevalência muda o tamanho das colunas; não muda a proporção dentro de cada uma. Há uma condição fina, que a diretriz também registra e que aparece na seção sobre vieses: isso vale enquanto o perfil e a gravidade dos pacientes forem os mesmos. Prevalência diferente por causa de espectro de doença diferente é outra coisa — e aí sensibilidade e especificidade podem, sim, mudar.
Vale nomear desde já os complementos, porque eles reaparecem na curva ROC. A fração de falsos-positivos é 1 − especificidade = b/(b+d). A fração de falsos-negativos é 1 − sensibilidade = c/(a+c). No exemplo acima: 1 − 0,53 = 0,47 de falsos-positivos e 1 − 0,64 = 0,36 de falsos-negativos.
VPP e VPN: as medidas que a prevalência move — e o cálculo que prova
O valor preditivo positivo é a probabilidade de o indivíduo ter realmente a doença, dado que apresentou um resultado positivo: VPP = a/(a+b). O valor preditivo negativo é a probabilidade de o indivíduo realmente não ter a doença, dado que apresentou um resultado negativo: VPN = d/(c+d). São medidas condicionadas ao resultado do teste — cada uma calculada dentro de uma linha só. É o que a pessoa sentada na sua frente pergunta: ela não quer saber o que o teste faz com os doentes em geral; ela quer saber o que o resultado dela significa.
Agora a demonstração. Pegue um único teste, com sensibilidade de 90% e especificidade de 90%, e aplique-o em dois cenários que diferem apenas na prevalência. Nada no teste muda: mesmo kit, mesmo ponto de corte, mesmo tipo de paciente.
Cenário 1 — ambulatório de referência, prevalência de 30%, 1.000 pacientes. Doentes: 30% de 1.000 = 300. Não-doentes: 700. A sensibilidade de 90% sobre 300 doentes dá a = 270 verdadeiros-positivos e deixa c = 30 falsos-negativos. A especificidade de 90% sobre 700 não-doentes dá d = 630 verdadeiros-negativos e deixa b = 70 falsos-positivos. Então: VPP = 270/(270+70) = 270/340 = 0,79, ou 79%. VPN = 630/(630+30) = 630/660 = 0,95, ou 95%.
Cenário 2 — inquérito populacional, prevalência de 1%, 10.000 pessoas. Doentes: 1% de 10.000 = 100. Não-doentes: 9.900. A sensibilidade de 90% sobre 100 doentes dá a = 90 verdadeiros-positivos e c = 10 falsos-negativos. A especificidade de 90% sobre 9.900 não-doentes dá d = 8.910 verdadeiros-negativos e b = 990 falsos-positivos. Então: VPP = 90/(90+990) = 90/1.080 = 0,083, ou 8,3%. VPN = 8.910/(8.910+10) = 8.910/8.920 = 0,999, ou 99,9%.
O veredito. O mesmo teste, com a mesma sensibilidade de 90% e a mesma especificidade de 90%, tem valor preditivo positivo de 79% num cenário e de 8,3% no outro. A causa é visível na conta: os falsos-positivos saem do grupo dos não-doentes, e quando a doença é rara esse grupo é enorme. Dez por cento de 9.900 pessoas são 990 falsos-positivos, contra apenas 90 verdadeiros-positivos — onze resultados positivos falsos para cada um verdadeiro. É exatamente o que a diretriz do Ministério da Saúde escreve: quando a prevalência é baixa, o valor preditivo positivo é baixo, independentemente dos valores de sensibilidade e especificidade.
A direção é sempre a mesma e vale guardá-la como regra fixa: prevalência sobe, o VPP sobe e o VPN cai; prevalência cai, o VPP cai e o VPN sobe. Metade das questões do tema se resolve só com essa direção, sem conta nenhuma. A outra metade pede o número, e aí a receita é a das duas contas acima: escolha um N redondo, quebre a população em doentes e não-doentes pela prevalência, aplique sensibilidade na coluna dos doentes e especificidade na dos não-doentes, e só então divida pela linha.
Um último detalhe que a diretriz registra e que ajuda a interpretar tabela de estudo: 'prevalência' na tabela 2×2 é (a+c)/N, a proporção de doentes segundo o padrão de referência. Se o estudo recrutou doentes e controles em números escolhidos pelo pesquisador — o chamado caso-controle diagnóstico —, essa proporção é um artefato do recrutamento, e qualquer VPP calculado a partir dela não descreve população nenhuma.
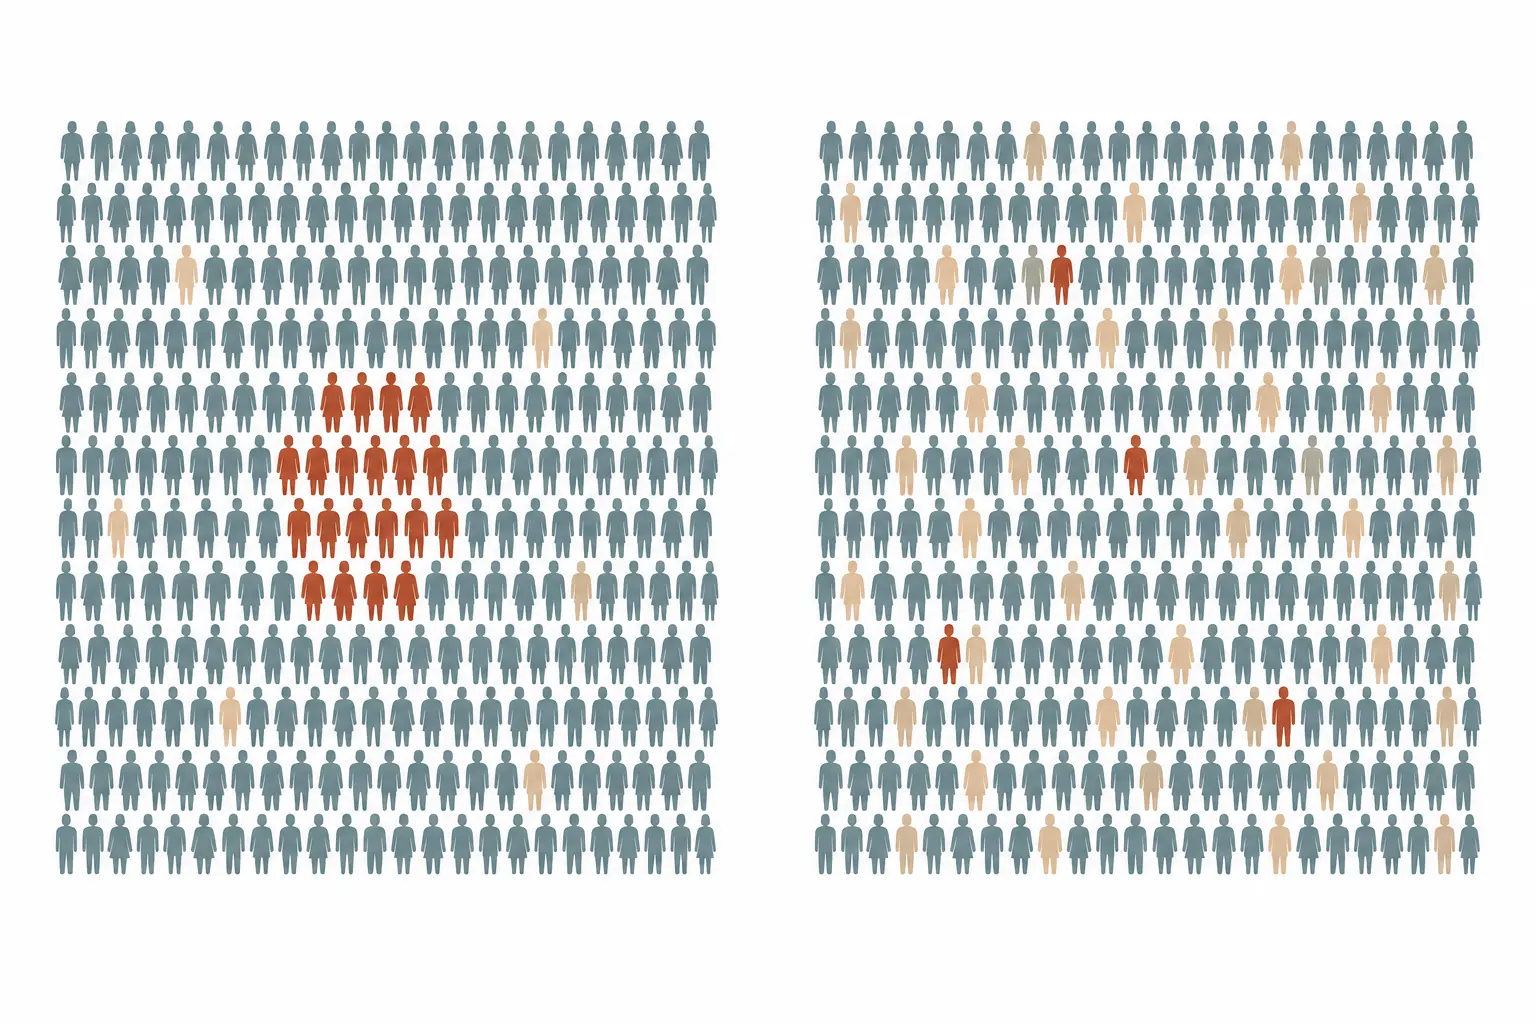
Acurácia: por que ela mente quando a doença é rara
A acurácia global é a proporção de acertos do teste: acurácia = (a+d)/N. Parece a medida definitiva — é o único número que olha as quatro casas de uma vez — e é a mais enganosa das cinco.
Ela tem dois problemas. O primeiro é que mistura as duas colunas num número só, com peso proporcional ao tamanho de cada uma: quanto maior a coluna dos não-doentes, mais a acurácia vira um retrato da especificidade. O segundo decorre do primeiro: como o peso vem do tamanho das colunas, a acurácia depende da prevalência. A própria diretriz do Ministério da Saúde lista a prevalência entre as fontes de viés justamente porque ela altera as estimativas que levam em conta dados de prevalência, e cita a acurácia como exemplo.
A demonstração é curta e brutal. No cenário de rastreamento da seção anterior — prevalência de 1%, teste com sensibilidade e especificidade de 90% —, a acurácia é (90 + 8.910)/10.000 = 9.000/10.000 = 90%. Agora imagine um 'teste' que responde negativo para todo mundo, sem olhar para o paciente, sem coletar nada. Ele erra os 100 doentes e acerta os 9.900 sadios: acurácia = 9.900/10.000 = 99%. O aparelho inútil tem acurácia melhor do que o teste bom, e sua sensibilidade é zero.
A consequência prática é que a acurácia só informa alguma coisa em duas condições: quando as duas colunas têm tamanho comparável e quando errar para um lado custa o mesmo que errar para o outro. Em medicina, a segunda condição quase nunca é verdadeira — deixar passar uma meningite não custa o mesmo que pedir uma tomografia a mais.
Se a prova pedir um resumo de acurácia que não dependa da prevalência, o candidato é o índice de Youden: sensibilidade + especificidade − 1. Ele varia de 0, quando o teste não tem valor diagnóstico, a 1, quando a acurácia é máxima, e atribui pesos iguais aos dois erros — falsos-negativos e falsos-positivos. No exemplo do rastreamento: 0,90 + 0,90 − 1 = 0,80. A diretriz do Ministério da Saúde registra que o índice não fornece interpretação probabilística direta; ele serve como índice geral, não como resposta clínica.
Razão de verossimilhança: a medida que atravessa a mudança de prevalência
A razão de verossimilhança positiva é a probabilidade de encontrar um teste positivo em quem tem a doença dividida pela probabilidade de encontrar um teste positivo em quem não tem. Em letras: RV+ = sensibilidade / (1 − especificidade), ou, direto da tabela, [a/(a+c)] / [b/(b+d)]. Ela responde a uma pergunta específica: quantas vezes é mais provável um resultado positivo em quem tem a doença do que em quem não a tem.
A razão de verossimilhança negativa faz o mesmo com o resultado negativo: RV− = (1 − sensibilidade) / especificidade, ou [c/(a+c)] / [d/(b+d)]. Quantas vezes é mais provável um resultado negativo em quem tem a doença do que em quem não tem.
A leitura é a mesma para as duas. Razão igual a 1 significa que o resultado é igualmente provável nos dois grupos — o teste não muda nada. Acima de 1, o resultado empurra a probabilidade para cima. Abaixo de 1, empurra para baixo. As faixas clássicas, de Jaeschke e colaboradores: RV+ acima de 10 ou RV− abaixo de 0,1 produzem mudanças grandes e frequentemente conclusivas; RV+ entre 5 e 10 ou RV− entre 0,1 e 0,2, mudanças moderadas; RV+ entre 2 e 5 ou RV− entre 0,2 e 0,5, mudanças pequenas, às vezes importantes; valores perto de 1 quase não mexem em nada.
Por que ela sobrevive à mudança de prevalência: porque é feita exclusivamente de sensibilidade e especificidade, duas medidas de coluna. Nenhum termo dela olha para o tamanho relativo das colunas. É por isso que a razão de verossimilhança é a medida que se pode carregar de um cenário para outro — do estudo publicado para o seu pronto-socorro — enquanto o VPP do artigo fica preso à população daquele artigo.
O motor é o teorema de Bayes escrito em forma de chance: chance pós-teste = chance pré-teste × razão de verossimilhança. Chance e probabilidade não são a mesma coisa, e a conversão é obrigatória nos dois sentidos: chance = p/(1 − p) e, de volta, p = chance/(1 + chance). Passo a passo com o rastreamento da seção anterior (sensibilidade e especificidade de 90%, prevalência de 1%). Chance pré-teste = 0,01/0,99 = 0,0101. RV+ = 0,90/(1 − 0,90) = 0,90/0,10 = 9. Chance pós-teste = 0,0101 × 9 = 0,0909. Probabilidade pós-teste = 0,0909/(1 + 0,0909) = 0,083, ou 8,3%.
Repare no que acabou de acontecer: 8,3% é exatamente o valor preditivo positivo que a tabela 2×2 tinha dado. As duas rotas chegam ao mesmo lugar, e essa identidade é útil como conferência na prova. A diferença é conceitual e vale ouro: a razão de verossimilhança pertence ao teste, e o valor preditivo pertence ao teste naquela população. Trocar a prevalência muda o segundo e deixa o primeiro intacto.
Existe ainda a razão de chances diagnóstica, que resume o desempenho num único número: RCD = RV+/RV− = (sens × espec) / [(1 − sens) × (1 − espec)] = (a×d)/(b×c). Ela tem pouca relevância clínica direta — não diz como um resultado específico muda a probabilidade —, mas aparece nas provas porque é o parâmetro central dos modelos de metanálise de estudos de acurácia.
Curva ROC e área sob a curva: o teste inteiro, não um ponto
Quando o teste devolve um número — glicemia, procalcitonina, um escore —, não existe 'positivo' antes de alguém escolher um ponto de corte. E cada corte escolhido gera um par sensibilidade/especificidade diferente. A curva ROC é o gráfico de todos esses pares, varrendo o limiar de positividade ao longo de todos os seus valores possíveis.
Os eixos, na convenção da diretriz do Ministério da Saúde: no eixo vertical (y) vai a sensibilidade, isto é, a fração de verdadeiros-positivos; no eixo horizontal (x) vai 1 − especificidade, isto é, a fração de falsos-positivos. Cada ponto da curva é um ponto de corte. Cuidado com essa leitura, porque é a pegadinha mais comum do gráfico: 1 − especificidade é falso-positivo, não falso-negativo. O falso-negativo é 1 − sensibilidade e mora no eixo vertical, como distância do ponto até o teto.
A geometria conta a história. A diagonal que vai de (0,0) a (1,1) é o teste que não discrimina nada: cada ponto de sensibilidade ganho custa exatamente um ponto de especificidade. Quanto mais a curva se afasta da diagonal em direção ao canto superior esquerdo, melhor o teste. O teste perfeito sairia da origem, subiria vertical até (0,1) e seguiria horizontal até (1,1): sensibilidade de 100% sem um único falso-positivo.
A área sob a curva resume a curva inteira num número. Ela tem uma interpretação intuitiva que vale decorar: é a probabilidade de que, sorteando ao acaso um doente e um não-doente, o valor do teste seja maior no doente. Os dois pontos ancorados pela diretriz brasileira: 0,5 é a diagonal, o teste sem aplicabilidade clínica; 1 é o teste perfeito.
As faixas de leitura entre esses dois extremos vêm da revisão metodológica de 2023 no Turkish Journal of Emergency Medicine: área maior ou igual a 0,90, excelente; de 0,80 a 0,89, considerável; de 0,70 a 0,79, razoável; de 0,60 a 0,69, fraca; de 0,50 a 0,59, falha. A série da Sociedade Brasileira de Pneumologia e Tisiologia usa um corte único e mais simples — valores acima de 0,8 indicam precisão muito boa. As duas leituras concordam no essencial: abaixo de 0,7 o teste discrimina mal, e a partir de 0,8 discrimina bem.
Uma limitação que a prova gosta de cobrar: a área sob a curva compara testes, mas não escolhe o ponto de corte. Dois testes com a mesma área podem ter curvas de formatos diferentes e servir a propósitos diferentes — um deles ótimo na região de alta sensibilidade, o outro na de alta especificidade. Escolher o ponto vem depois, e vem da clínica, não da geometria.
O ponto de corte: quando se prefere sensível, quando se prefere específico
Mover o ponto de corte é um jogo de soma quase zero. Baixar o limiar de positividade — chamar mais gente de positiva — sobe a sensibilidade e derruba a especificidade. Subir o limiar faz o contrário: menos positivos, especificidade alta, sensibilidade baixa. Não existe corte que melhore as duas ao mesmo tempo; se existisse, o teste seria outro. A diretriz do Ministério da Saúde é explícita: a escolha do limiar envolve uma decisão entre aumentar a sensibilidade à custa de reduzir a especificidade, e vice-versa.
Prefere-se um teste (ou um corte) sensível quando o desastre é o falso-negativo. É o caso do rastreamento populacional, em que perder o caso significa perder a janela de tratamento; das doenças graves e tratáveis, em que o custo de não diagnosticar é desproporcional; e das situações em que o falso-positivo só gera um exame confirmatório a mais. A diretriz dá o exemplo do teste em suspeita de infecção pelo HIV e a regra: se a preocupação maior é evitar o falso-negativo, o corte deve buscar o máximo de sensibilidade. O material didático brasileiro dá o exemplo da triagem sorológica em banco de sangue, em que se persegue 100% de sensibilidade aceitando o aumento de falsos-positivos, porque a não detecção acarreta risco para a população.
Prefere-se um teste (ou um corte) específico quando o desastre é o falso-positivo. É o caso da confirmação diagnóstica e das situações em que o resultado positivo dispara um tratamento tóxico, uma cirurgia de risco ou um rótulo pesado. Mesma diretriz, mesma frase invertida: se a principal preocupação é evitar o resultado falso-positivo — porque o resultado do teste pode indicar uma cirurgia arriscada para o paciente —, o corte deve buscar o máximo de especificidade.
A arquitetura padrão do rastreamento usa as duas coisas em ordem: um teste sensível na frente, para não perder ninguém, e um teste específico atrás, para limpar os falsos-positivos do primeiro. Praticamente todo programa de rastreamento tem essa forma, e ela explica por que um valor preditivo positivo baixo na triagem não condena o programa: a triagem não fecha diagnóstico, ela seleciona quem vai para o exame confirmatório.
Testes em série e em paralelo
Quando se combinam dois testes, o critério de positividade do conjunto decide tudo. Em paralelo, os testes são aplicados ao mesmo tempo e basta um resultado positivo para o conjunto ser considerado positivo. Isso captura todo mundo que qualquer um dos testes pegaria: a sensibilidade do conjunto sobe, ficando acima da do teste mais sensível isolado. Em troca, o conjunto herda os falsos-positivos dos dois testes, e a especificidade cai.
Em série, os testes são aplicados em sequência e só é considerado positivo quem for positivo em todos. Isso exige concordância: a especificidade do conjunto sobe, ficando acima da do teste mais específico isolado, porque um falso-positivo do primeiro teste é filtrado pelo segundo. Em troca, basta um dos testes falhar para o caso escapar, e a sensibilidade cai.
Se preferir uma frase só, guarde esta: 'ou' aumenta sensibilidade, 'e' aumenta especificidade. Paralelo é 'ou' — positivo em A ou em B. Série é 'e' — positivo em A e em B. A confusão desaparece quando você percebe que exigir menos para chamar de positivo sempre aumenta a sensibilidade, e exigir mais sempre aumenta a especificidade.
Cada arranjo tem seu cenário. O paralelo serve à emergência e ao rastreamento, quando não há tempo de esperar e perder o caso é o pior desfecho. A série serve à consulta e ao seguimento, quando há tempo para confirmar e o custo do falso-positivo é alto — é o arranjo clássico da triagem sensível seguida de confirmação específica, e é a forma como os programas do SUS estão desenhados.
Vieses do estudo de acurácia: espectro, verificação e incorporação
Todo número deste capítulo vem de um estudo, e estudo de acurácia diagnóstica tem um desenho próprio, que a diretriz do Ministério da Saúde descreve com precisão: é transversal por definição, com uma série consecutiva de pacientes com suspeita da doença-alvo, todos submetidos ao teste índice e todos submetidos ao mesmo padrão de referência, com os dois testes interpretados por pessoas cegas em relação ao resultado do outro, e com intervalo curto o bastante entre eles para que a doença não mude de estágio no meio do caminho. Cada desvio desse desenho tem nome, e a banca cobra o nome.
Viés de espectro. O desempenho de um teste muda conforme o perfil e a gravidade dos pacientes incluídos — características demográficas e gravidade da doença são o que a diretriz chama de espectro da doença, e as lista como fontes de variação entre estudos. O estudo que compara doentes muito graves contra controles sadios (o desenho de caso-controle diagnóstico) produz sensibilidade e especificidade infladas, porque o teste está separando extremos e não a mistura ambígua que aparece no consultório. O verdadeiro valor de um teste diagnóstico só se estabelece, escreve a diretriz, em estudos que incluem pacientes parecidos com os da prática clínica — pacientes sem nenhum achado óbvio que já confirme ou exclua o diagnóstico.
Viés de verificação, também chamado de work-up bias. Ocorre quando todos fazem o teste índice, mas apenas parte dos pacientes segue para o padrão de referência — tipicamente porque o padrão é invasivo (uma biópsia, por exemplo) e só se encaminha quem testou positivo. O efeito, na descrição da própria diretriz: como a grande maioria dos verificados terá resultado positivo no teste índice, a sensibilidade fica superestimada; e como pouquíssimos pacientes sem a doença chegam a ter o resultado negativo confirmado, a especificidade fica subestimada.
Viés de incorporação. Ocorre quando o resultado do teste índice entra na composição do padrão de referência — os dois deixam de ser independentes. O efeito é a superestimação tanto da sensibilidade quanto da especificidade, porque o teste está, em parte, sendo comparado consigo mesmo. Aparece com frequência quando o padrão de referência é um 'diagnóstico clínico final' montado por um comitê que teve acesso ao exame em avaliação, ou quando o padrão é composto por uma bateria de exames que inclui o próprio teste índice.
Viés de inspeção. O leitor de um dos testes conhece o resultado do outro e é influenciado por ele; a prevenção é a leitura cega dos dois lados. A diretriz separa ainda duas variantes úteis de conhecer: o viés de inspeção clínica, em que a disponibilidade de idade, sexo, sintomas e comorbidades durante a leitura afeta a estimativa; e o viés de contexto, em que quem interpreta o teste num cenário de alta prevalência tende a classificar mais exames como anormais.
As duas ferramentas que a prova pode citar pelo nome. Para avaliar o risco de viés de um estudo de acurácia, o padrão é o QUADAS-2, estruturado em quatro domínios: seleção de pacientes, teste índice, padrão de referência, e fluxo e tempo. Cada domínio é julgado como risco baixo, alto ou incerto, sem soma de pontuação — a diretriz é explícita ao recomendar contra escores de qualidade, porque eles atribuem peso igual a itens cuja importância varia com o contexto. Para o relato do estudo, o padrão é o STARD 2015: uma lista de 30 itens essenciais, agrupados em seis domínios (título e resumo, introdução, métodos, resultados, discussão e outras informações).
Reprodutibilidade: concordância bruta e kappa
Antes de perguntar se um teste é válido, vale perguntar se ele é reprodutível: dois observadores lendo o mesmo exame chegam ao mesmo laudo? Reprodutibilidade alta não garante validade — os dois podem estar igualmente errados —, mas reprodutibilidade baixa limita tudo o que vem depois. A diretriz do Ministério da Saúde lista a variabilidade de observação entre as fontes de variação dos estudos de acurácia justamente por isso.
A medida ingênua é a concordância bruta: a proporção de leituras em que os dois observadores disseram a mesma coisa. O problema é que parte dessa concordância acontece por puro acaso, e a fatia do acaso cresce quanto mais desbalanceadas forem as categorias — ou seja, quanto mais rara a doença.
O kappa desconta o acaso: κ = (Po − Pe) / (1 − Pe), onde Po é a proporção de concordâncias observadas e Pe a proporção de concordâncias esperadas apenas pelo acaso, calculada a partir das margens da tabela. Nas letras da tabela 2×2 de concordância: Po = (a+d)/N e Pe = [(a+b)(a+c) + (c+d)(b+d)] / N².
O cálculo, com o exemplo resolvido do material didático. Cento e vinte lâminas de gota espessa para pesquisa de malária foram lidas por dois microscopistas independentes. Os dois concordaram em 18 lâminas positivas e em 88 negativas; discordaram em 14. Po = (18 + 88)/120 = 106/120 = 0,883 — 88,3% de concordância bruta, um número que parece excelente. Agora o acaso: o primeiro microscopista achou 20 positivas e 100 negativas; o segundo achou 30 positivas e 90 negativas. Pe = [(30 × 20) + (90 × 100)] / 120² = (600 + 9.000)/14.400 = 0,667. Logo κ = (0,883 − 0,667)/(1 − 0,667) = 0,217/0,333 = 0,65. Uma concordância 'de 88%' vira um kappa de 0,65, porque dois terços daquela concordância já eram esperados sem que ninguém olhasse a lâmina.
A escala de leitura, adaptada de Landis e Koch: abaixo de 0, nenhuma concordância; de 0 a 0,20, fraca; de 0,21 a 0,40, sofrível; de 0,41 a 0,60, regular; de 0,61 a 0,80, boa; de 0,81 a 0,99, ótima; 1,00, perfeita. O kappa de 0,65 do exemplo cai, portanto, em concordância boa.
Duas advertências de interpretação. A primeira: o kappa depende da prevalência do achado — prevalências muito baixas puxam o kappa para baixo mesmo com o procedimento bem executado, porque a concordância esperada pelo acaso fica alta. Por isso a prevalência deve ser informada junto com o resultado do kappa, e por isso um kappa medíocre nem sempre acusa um método ruim. A segunda: reduzir o número de categorias (positivo/negativo em vez de quatro graus) tende a aumentar a concordância artificialmente — comparar kappas de escalas com números diferentes de categorias não faz sentido.
Régua de cálculo — a tabela 2×2 e as cinco divisões que saem dela
Monte a tabela antes de qualquer conta. Depois é só escolher o denominador: dividir pelo total de uma COLUNA condiciona à doença (sensibilidade, especificidade); dividir pelo total de uma LINHA condiciona ao resultado do teste (valor preditivo positivo, valor preditivo negativo). A tabela abaixo é as duas coisas ao mesmo tempo — o esqueleto 2×2 e a fórmula que sai de cada margem, com a informação que decide a maioria das questões: se aquela medida se mexe ou não quando a prevalência muda.
- 1Separe os dois eixos do enunciado: o que define a VERDADE (padrão de referência: biópsia, cultura, seguimento, autópsia) vai nas colunas; o que está sendo AVALIADO (teste índice) vai nas linhas. Se a prova desenhou ao contrário, redesenhe antes de calcular.
- 2Preencha a, b, c e d. Se o enunciado der percentuais em vez de contagens, invente um N redondo — 1.000, 10.000 ou 100.000 — grande o bastante para que a prevalência caia em número inteiro de pessoas.
- 3Quebre a população pela prevalência ANTES de aplicar o teste: primeiro quantos têm a doença e quantos não têm; só então aplique a sensibilidade sobre a coluna dos doentes e a especificidade sobre a coluna dos não-doentes.
- 4Some as quatro margens antes de dividir: doentes (a+c), não-doentes (b+d), testes positivos (a+b), testes negativos (c+d). Metade dos erros deste tema é denominador trocado, não conta errada.
- 5Identifique o que a questão pede pela forma da pergunta. 'Dos doentes, quantos o teste detecta?' é coluna. 'Dado este resultado positivo, qual a chance de a pessoa estar doente?' é linha.
- 6Se a questão mexeu apenas na prevalência, não recalcule sensibilidade nem especificidade — elas não mudam. Recalcule VPP, VPN e acurácia, e lembre a direção: prevalência sobe, VPP sobe e VPN cai.
- 7Se a questão pede o desempenho do teste independentemente do cenário, ou pede para levar um resultado de um serviço para outro, vá para as razões de verossimilhança: RV+ = S/(1−E) e RV− = (1−S)/E.
AUC ≥ 0,90 — excelente
A curva cola no canto superior esquerdo: existe ponto de corte com sensibilidade alta pagando pouquíssimo falso-positivo. A linha tracejada é a diagonal do acaso.
AUC 0,80–0,89 — considerável
Discrimina bem, mas cada ganho de sensibilidade já custa especificidade visível. É a faixa em que a escolha do ponto de corte passa a decidir o uso clínico.
AUC 0,50–0,59 — falha
A curva quase encosta na diagonal: o teste não separa doentes de não-doentes melhor que o acaso. Entre as pontas ficam 0,70–0,79 (razoável) e 0,60–0,69 (fraca).
| Tabela 2×2 | Doença PRESENTE (padrão de referência +) | Doença AUSENTE (padrão de referência −) | Lendo a LINHA — condiciona ao RESULTADO do teste |
|---|---|---|---|
| Teste índice POSITIVO | a — verdadeiro-positivo | b — falso-positivo | VPP = a/(a+b). Dado um teste positivo, qual a probabilidade de ter a doença. MUDA com a prevalência (sobe quando ela sobe). |
| Teste índice NEGATIVO | c — falso-negativo | d — verdadeiro-negativo | VPN = d/(c+d). Dado um teste negativo, qual a probabilidade de não ter a doença. MUDA com a prevalência (cai quando ela sobe). |
| Lendo a COLUNA — condiciona à DOENÇA | Sensibilidade = a/(a+c). Dos doentes, quantos o teste detecta. NÃO muda com a prevalência. Complemento: 1 − S = c/(a+c) é a fração de falsos-negativos. | Especificidade = d/(b+d). Dos não-doentes, quantos o teste libera. NÃO muda com a prevalência. Complemento: 1 − E = b/(b+d) é a fração de falsos-positivos (eixo x da curva ROC). | Acurácia = (a+d)/N. Proporção global de acertos. MUDA com a prevalência — e engana quando a doença é rara, porque a coluna dos não-doentes domina o cálculo. |
Derivadas apenas das duas medidas de coluna e, por isso, imunes à prevalência: RV+ = sensibilidade/(1 − especificidade); RV− = (1 − sensibilidade)/especificidade; índice de Youden = sensibilidade + especificidade − 1 (0 = sem valor diagnóstico, 1 = acurácia máxima); razão de chances diagnóstica = RV+/RV− = (a×d)/(b×c).
Para transformar razão de verossimilhança em probabilidade: chance pré-teste = prevalência/(1 − prevalência); chance pós-teste = chance pré-teste × razão de verossimilhança; probabilidade pós-teste = chance/(1 + chance). A probabilidade pós-teste de um resultado positivo é o próprio VPP naquela população — use isso como conferência do cálculo pela tabela.
Faixas de razão de verossimilhança (Jaeschke e col., 1994): RV+ acima de 10 ou RV− abaixo de 0,1 mudam muito a probabilidade e frequentemente decidem a conduta; RV+ de 5 a 10 ou RV− de 0,1 a 0,2, mudança moderada; RV+ de 2 a 5 ou RV− de 0,2 a 0,5, mudança pequena; valores próximos de 1 não mudam quase nada.
Reprodutibilidade entre observadores: κ = (Po − Pe)/(1 − Pe), com Po = (a+d)/N e Pe = [(a+b)(a+c) + (c+d)(b+d)]/N². Leitura adaptada de Landis e Koch (1977): abaixo de 0 nenhuma; 0 a 0,20 fraca; 0,21 a 0,40 sofrível; 0,41 a 0,60 regular; 0,61 a 0,80 boa; 0,81 a 0,99 ótima; 1,00 perfeita.
Combinação de testes: em paralelo (positivo se UM for positivo, critério 'ou') a sensibilidade do conjunto sobe e a especificidade cai; em série (positivo só se TODOS forem positivos, critério 'e') a especificidade sobe e a sensibilidade cai.
Onde as fontes divergem
Nestes pontos as fontes não dizem a mesma coisa. Cada posição vem com quem a sustenta — e com o que fazer diante de uma vinheta de prova.
Critério estatístico — o ponto que maximiza o par sensibilidade/especificidade
Escolhe-se, sobre a curva ROC, o ponto que fornece as maiores sensibilidade e especificidade possíveis para aquele teste — o ponto mais próximo do canto superior esquerdo, equivalente ao máximo do índice de Youden. É a prática mais frequente nos estudos primários que derivam um corte novo.
Ministério da Saúde, Diretrizes metodológicas: estudos de acurácia diagnóstica (2014), Apêndice 4: 'Muitos autores preferem definir este limiar baseado no ponto que maximiza a curva. Esse ponto fornecerá as maiores sensibilidades e especificidades possíveis para o teste.'
Critério clínico — a intenção do teste e o custo de cada erro
O corte é definido pela consequência dos dois erros no cenário em que o teste vai ser usado: se o falso-negativo é o desastre (rastreamento, doença grave e tratável, triagem de banco de sangue), busca-se o máximo de sensibilidade; se o falso-positivo dispara procedimento de risco, busca-se o máximo de especificidade. O ponto estatisticamente ótimo pode não ser o clinicamente aceitável.
Ministério da Saúde, Diretrizes metodológicas (2014), Apêndice 4 ('a estratégia geral seria dependente da intenção do teste'; exemplos da cirurgia arriscada e da suspeita de HIV) e Anexo E, que classifica a escolha do limiar que maximiza sensibilidade e especificidade como fonte de superestimação das medidas de desempenho. Mesma orientação no material didático de epidemiologia da Universidade Federal de Goiás (triagem sorológica em banco de sangue).
Na prova
O enunciado entrega qual dos dois critérios a questão está usando. Se o texto fala em curva ROC, 'melhor ponto de corte', índice de Youden ou 'ponto mais próximo do canto superior esquerdo', o recorte é estatístico e o item cobrado é a geometria. Se o texto descreve o cenário de uso — programa de rastreamento do SUS, banco de sangue, triagem de doença grave e tratável, ou um resultado positivo que indica cirurgia —, o recorte é clínico e o item cobrado é a consequência do erro, não a curva. As alternativas também denunciam: distrator que traz um valor numérico de corte sem dizer para que o teste serve pertence ao mundo estatístico; distrator que fala em 'evitar deixar passar casos' ou 'evitar submeter paciente saudável a procedimento invasivo' pertence ao clínico. Vale a régua geral: prova oficial do MEC tende a cenário e conduta SUS, o que empurra o recorte para o critério clínico; outras bancas dependem do que as alternativas revelam.
Corte único em 0,8 (Sociedade Brasileira de Pneumologia e Tisiologia, 2018)
A série de educação continuada do Jornal Brasileiro de Pneumologia adota um limiar de leitura único: valores de área sob a curva acima de 0,8 indicam que a precisão do teste diagnóstico é muito boa. A série não subdivide o que está abaixo disso.
Ferreira JC, Patino CM. Entendendo os testes diagnósticos. Parte 3. J Bras Pneumol. 2018;44(1):4.
Escala ordinal em cinco faixas (revisão metodológica de 2023)
Área maior ou igual a 0,90, excelente; de 0,80 a 0,89, considerável; de 0,70 a 0,79, razoável; de 0,60 a 0,69, fraca; de 0,50 a 0,59, falha. A escala separa graus que o corte único agrupa e sustenta que a área sozinha não decide a utilidade clínica do teste.
Çorbacıoğlu ŞK, Aksel G. Receiver operating characteristic curve analysis in diagnostic accuracy studies. Turk J Emerg Med. 2023;23(4):195-198, Tabela 2.
Apenas os dois extremos ancorados (diretriz metodológica brasileira, 2014)
A diretriz do Ministério da Saúde não propõe faixas intermediárias. Registra apenas que o valor de 0,5 é obtido quando o teste não tem aplicabilidade clínica — é a diagonal do gráfico — e o valor de 1 quando o teste é perfeito, com a curva passando por (0,1).
Ministério da Saúde, Diretrizes metodológicas: estudos de acurácia diagnóstica (2014), p. 48 e Apêndice 4.
Na prova
Questão que pede um rótulo verbal para um valor de área sob a curva ('a acurácia global deste teste pode ser classificada como...') está usando alguma escala ordinal, e as próprias alternativas mostram qual: se aparecem cinco graus, é a escala em faixas; se o item é dicotômico entre 'boa' e 'insuficiente', o corte único costuma ficar em 0,8. Questão que pede interpretação sem rótulo verbal quase sempre se resolve pelos dois extremos ancorados: 0,5 é o acaso, 1 é o teste perfeito, e o que interessa é a distância até a diagonal. Enunciado que cita nominalmente uma sociedade brasileira, ou que se passa em ambiente do SUS, tende a trabalhar com o corte único; enunciado de leitura crítica de artigo, com metodologia detalhada, tende a trabalhar com a escala em faixas.
Caso resolvido
- monte a 2×2
- Colunas: biópsia (o padrão de referência). Linhas: exame físico (o teste índice). a = 1.800 verdadeiros-positivos. c = 2.500 − 1.800 = 700 falsos-negativos. b = 800 falsos-positivos. d = 5.000 − 800 = 4.200 verdadeiros-negativos. Margens: 2.500 doentes, 5.000 não-doentes, 2.600 testes positivos, 4.900 testes negativos, N = 7.500.
- sensibilidade
- a/(a+c) = 1.800/2.500 = 0,72, ou 72%. O exame físico detecta 72% das mulheres que realmente têm o câncer. O complemento importa tanto quanto: 28% — 700 mulheres — recebem um exame normal e saem falsamente tranquilizadas.
- especificidade
- d/(b+d) = 4.200/5.000 = 0,84, ou 84%. Entre as mulheres sem câncer, 84% recebem exame negativo. As outras 16% — 800 mulheres — são chamadas de volta por um achado que a biópsia não confirma.
- VPP e VPN
- VPP = a/(a+b) = 1.800/2.600 = 0,69, ou 69%. VPN = d/(c+d) = 4.200/4.900 = 0,86, ou 86%. Note que os denominadores mudaram de direção: agora se divide pelas linhas, não pelas colunas.
- acurácia
- (a+d)/N = (1.800 + 4.200)/7.500 = 6.000/7.500 = 0,80, ou 80%. Ela caiu entre a sensibilidade (72%) e a especificidade (84%), puxada para o lado da coluna maior — a dos não-doentes, que aqui tem o dobro do tamanho da outra.
- verossimilhança
- RV+ = 0,72/(1 − 0,84) = 0,72/0,16 = 4,5: um resultado positivo é 4,5 vezes mais provável em quem tem o câncer do que em quem não tem — mudança pequena a moderada, pela faixa de 2 a 5. RV− = (1 − 0,72)/0,84 = 0,28/0,84 = 0,33: um resultado negativo mal reduz a probabilidade, também na faixa de mudança pequena. Razão de chances diagnóstica = 4,5/0,33 = 13,5, que confere com (1.800 × 4.200)/(800 × 700) = 7.560.000/560.000 = 13,5. Índice de Youden = 0,72 + 0,84 − 1 = 0,56.
- a pegadinha
- A 'prevalência' desta tabela é 2.500/7.500 = 33%. Ela não é a prevalência de câncer de mama em população nenhuma — é uma proporção que o pesquisador criou ao recrutar uma doente para cada duas controles. O desenho é um caso-controle diagnóstico, em que o estado de doença já era conhecido antes de a paciente ser submetida ao teste índice.
- o que se leva
- Sensibilidade, especificidade e as duas razões de verossimilhança sobrevivem ao desenho e podem ser levadas adiante. O VPP de 69% não pode: numa população real, em que o câncer de mama está muitíssimo abaixo de 33%, ele seria uma fração disso. E há um alerta adicional: comparar doentes com biópsia confirmada contra controles pareados é o cenário clássico do viés de espectro — os dois grupos são extremos, e sensibilidade e especificidade tendem a sair melhores do que sairiam numa série consecutiva de mulheres com queixa mamária, que é onde o exame de fato é usado.
Agora feche você
- escolha o N
- Adote uma população de 100.000 pessoas, grande o bastante para que uma prevalência de 12/1.000 (1,2%) caia em número inteiro: 1.200 pessoas têm câncer de cólon e 98.800 não têm.
- preencha
- Sensibilidade de 70% sobre os 1.200 doentes: a = 840 verdadeiros-positivos e c = 360 falsos-negativos. Especificidade de 75% sobre os 98.800 não-doentes: d = 74.100 verdadeiros-negativos e b = 24.700 falsos-positivos.
- VPP
- …
- o veredito
- …
Onde a banca derruba
- 1Dividir pelo denominador da direção errada. É o erro número um do tema, e ele não parece erro: o numerador está certo. Verdadeiro-positivo sobre o total de testes positivos é VPP; verdadeiro-positivo sobre o total de doentes é sensibilidade. Antes de dividir, pergunte se o enunciado está condicionando à doença (coluna) ou ao resultado do teste (linha).
- 2Dizer que a sensibilidade caiu porque a prevalência caiu. Atrai porque o número absoluto de casos detectados realmente cai. Mas sensibilidade é uma proporção calculada dentro da coluna dos doentes: se a coluna encolhe, numerador e denominador encolhem juntos e a proporção fica onde estava. Só VPP, VPN e acurácia se mexem quando muda apenas a prevalência.
- 3Julgar teste de doença rara pela acurácia. Num cenário com 1% de prevalência, um aparelho que respondesse 'negativo' para todo mundo teria 99% de acurácia e sensibilidade zero. A acurácia mistura as duas colunas com peso proporcional ao tamanho delas, e em doença rara a coluna dos sadios domina o resultado.
- 4Confundir 1 − especificidade com falso-negativo. 1 − especificidade é a fração de falsos-POSITIVOS, b/(b+d), e é ela que ocupa o eixo horizontal da curva ROC. A fração de falsos-negativos é 1 − sensibilidade, c/(a+c), e mora no eixo vertical. Trocar as duas inverte a leitura do gráfico inteiro.
- 5Tratar teste sensível como teste que confirma. Sensibilidade alta serve ao resultado NEGATIVO: poucos falsos-negativos, então um negativo afasta bem a doença. Especificidade alta serve ao resultado POSITIVO: poucos falsos-positivos, então um positivo confirma bem. A alternativa que diz 'teste altamente sensível, portanto o resultado positivo confirma o diagnóstico' trocou as duas pontas.
- 6Levar o VPP de um caso-controle diagnóstico para a clínica. Quando o estudo recruta N doentes e M controles, a prevalência da tabela foi escolhida pelo pesquisador, não medida numa população. Sensibilidade, especificidade e razões de verossimilhança sobrevivem a isso; VPP, VPN e acurácia, não.
- 7Ler a área sob a curva como taxa de acerto do teste. A área sob a curva não é 'porcentagem de acertos'. É a probabilidade de que, sorteando um doente e um não-doente, o doente tenha o valor mais alto do teste — e resume a curva inteira, não o desempenho num corte específico. Um teste com área de 0,95 ainda pode ter sensibilidade ruim no corte que o seu serviço adota.
- 8Trocar o efeito do arranjo em série pelo do arranjo em paralelo. Paralelo é 'ou' — basta um positivo — e sobe a sensibilidade às custas da especificidade. Série é 'e' — precisa dos dois — e sobe a especificidade às custas da sensibilidade. A confusão aumenta quando o enunciado descreve o arranjo em vez de nomeá-lo: leia o critério de positividade do conjunto, não o nome.
- 9Confundir concordância bruta com kappa. No exemplo das lâminas de malária, 88,3% de concordância bruta viraram um kappa de 0,65, porque dois terços daquela concordância eram esperados só pelo acaso. Quanto mais rara a categoria positiva, maior a fatia do acaso e menor o kappa para a mesma concordância bruta.
- 10Chamar de viés de incorporação o que é viés de verificação. Verificação (work-up) é quando nem todos vão ao padrão de referência, tipicamente porque ele é invasivo — infla a sensibilidade e derruba a especificidade. Incorporação é quando o teste índice faz parte do próprio padrão de referência — infla as duas. O gatilho no enunciado é diferente: 'apenas os pacientes com teste positivo foram submetidos à biópsia' é verificação; 'o diagnóstico final foi estabelecido por um comitê que teve acesso ao exame em estudo' é incorporação.
Verdadeiros positivos = 90; falsos positivos = 900 − 810 = 90. VPP = VP/(VP+FP) = 90/(90+90) = 90/180 = 50%. 90% é a sensibilidade (90/100), não o VPP. 10% seria a proporção de falsos negativos entre doentes. 81% aproxima a especificidade (810/900 = 90%), mas ainda não é o VPP. 9% não corresponde a nenhum indicador correto. Como a prevalência é baixa e há muitos falsos positivos, o VPP cai para 50%.
Recuperação
Responda as 10 — o gabarito e o comentário de cada uma abrem a cada questão ou só no fim, como você preferir.
Um novo teste diagnóstico para determinada infecção foi avaliado em 1.000 pessoas. Entre os 200 doentes, o teste foi positivo em 180; entre os 800 não doentes, o teste foi positivo em 80. Considerando esses dados, quais são, respectivamente, a SENSIBILIDADE e o VALOR PREDITIVO POSITIVO do teste nessa população?
Sensibilidade = verdadeiros positivos/doentes = 180/200 = 90%. VPP = VP/(VP+FP) = 180/(180+80) = 180/260 ≈ 69% (correta). A opção com sensibilidade 69% inverte os conceitos. VPP de 90% ignora os 80 falsos-positivos. Sensibilidade 80% erra o numerador/denominador. VPP de 96% corresponderia à especificidade (720/800 = 90%) ou a cálculo trocado, não ao VPP.
Um novo teste diagnóstico para uma doença é avaliado. Em uma população de 1000 pessoas, 200 têm a doença. O teste foi positivo em 180 dos doentes e em 80 dos não doentes. Qual é a sensibilidade do teste?
Sensibilidade = verdadeiros positivos / total de doentes = 180/200 = 90%. Os 80 positivos entre não doentes são falso-positivos e afetam a especificidade (800-80=720 verdadeiros negativos; especificidade=720/800=90%), não a sensibilidade. 69% corresponderia ao valor preditivo positivo (180/260). 92% e 75% não correspondem a nenhum parâmetro correto neste cenário.
Um novo teste diagnóstico para uma infecção é avaliado em população com prevalência de 20%. O teste tem sensibilidade de 90% e especificidade de 80%. Aplicando-o em 1.000 pessoas, qual é aproximadamente o valor preditivo positivo (VPP)?
Com prevalência 20%: 200 doentes, 800 sadios. VP = 0,90×200 = 180; FP = 0,20×800 = 160. VPP = 180/(180+160) = 180/340 ≈ 53% (correta). 36% ignora que o denominador soma VP+FP. 72% confunde com outra razão. 90% é a sensibilidade, não o VPP. 18% seria proporção de verdadeiro-positivos sobre o total, sem relação com VPP. O baixo VPP mesmo com boa sensibilidade ilustra o efeito da prevalência.
Em um município com 200.000 habitantes, a equipe de vigilância epidemiológica avalia um novo teste de triagem para determinada infecção. Aplicado a 1.000 pessoas, o teste apresentou os seguintes resultados: entre os 100 verdadeiramente doentes, 90 tiveram teste positivo; entre os 900 não doentes, 810 tiveram teste negativo. Considerando esses dados, qual é o valor preditivo positivo (VPP) do teste nessa população?
VPP = verdadeiros positivos / (verdadeiros positivos + falsos positivos). VP = 90; FP = 900 − 810 = 90; VPP = 90/(90+90) = 50%. A alternativa '90%' corresponde à sensibilidade (90/100), não ao VPP. '81%' é a especificidade (810/900). '10%' é a prevalência (100/1.000). '33%' não corresponde a nenhum parâmetro calculável com esses dados, servindo como distrator plausível para quem inverte a fórmula.
Um novo teste diagnóstico para determinada infecção foi avaliado em 1.000 pessoas. Entre os 200 realmente doentes, o teste foi positivo em 180. Entre os 800 não doentes, o teste foi negativo em 760. Um paciente dessa mesma população recebe resultado POSITIVO. Qual é, aproximadamente, o valor preditivo positivo do teste?
Sensibilidade = 180/200 = 90%; especificidade = 760/800 = 95%. Falsos-positivos = 800 − 760 = 40. VPP = verdadeiros-positivos / (VP + FP) = 180 / (180 + 40) = 180/220 ≈ 82%. As demais opções confundem: 90% é a sensibilidade, 95% a especificidade, 97% seria o valor preditivo negativo (760/[760+20]≈97%) e 45% não corresponde a nenhum parâmetro correto.
Um novo teste diagnóstico para determinada infecção foi avaliado em 1.000 pessoas. Entre os 200 realmente doentes, o teste foi positivo em 180. Entre os 800 não doentes, o teste foi positivo em 80. Qual é o valor preditivo positivo desse teste nesta população?
Correta (69%): VPP = verdadeiros positivos / (verdadeiros positivos + falsos positivos) = 180/(180+80) = 180/260 ≈ 0,692 = 69%. '90%' é a sensibilidade (180/200). '88%' é aproximadamente a especificidade complementar mal calculada. '72%' e '50%' não correspondem ao cálculo do VPP com esses dados.
Um novo teste rápido para triagem de uma infecção assintomática foi avaliado. Em uma população de 1.000 pessoas, 100 realmente têm a doença. O teste identificou corretamente 90 doentes e apontou como positivos 180 pessoas no total. Com base nesses dados, qual é a sensibilidade e o valor preditivo positivo do teste, respectivamente?
Sensibilidade = verdadeiros positivos / total de doentes = 90/100 = 90%. VPP = verdadeiros positivos / total de positivos no teste = 90/180 = 50%. As demais alternativas trocam os numeradores/denominadores (confundem sensibilidade com VPP ou erram os cálculos), gerando valores incompatíveis com os dados apresentados.
Um novo teste rápido para triagem de determinada infecção é avaliado em uma população onde a prevalência da doença é de 2%. O teste tem sensibilidade de 95% e especificidade de 90%. Um agente comunitário pergunta ao médico qual a probabilidade de uma pessoa com teste POSITIVO realmente ter a doença. Qual é, aproximadamente, o valor preditivo positivo nesse cenário?
Em 10.000 pessoas: doentes = 200, sadios = 9.800. Verdadeiros-positivos = 0,95×200 = 190; falsos-positivos = 0,10×9.800 = 980. VPP = 190/(190+980) ≈ 16%. O valor 95% é a sensibilidade, não o VPP. O valor 90% é a especificidade. O valor 50% seria plausível apenas em prevalência muito alta. O valor 2% é a prevalência (probabilidade pré-teste). A baixa prevalência derruba o VPP mesmo com boa sensibilidade/especificidade.
Uma UBS quer avaliar a acurácia de um novo teste rápido para rastreamento de determinada infecção em sua população. Aplicando o teste em 1.000 pessoas, obteve-se: 90 verdadeiros-positivos, 10 falsos-negativos, 180 falsos-positivos e 720 verdadeiros-negativos. A gestão pergunta ao médico qual característica do teste é mais relevante para uma boa estratégia de RASTREAMENTO populacional e qual o valor obtido. Qual afirmativa está correta?
Em rastreamento (screening) prioriza-se ALTA SENSIBILIDADE, para não deixar escapar doentes (poucos falsos-negativos). Sensibilidade = VP/(VP+FN) = 90/(90+10) = 90% (correta). A especificidade aqui é 720/(720+180) = 80% — e ela é prioridade em testes confirmatórios, não no rastreamento. O valor preditivo positivo = 90/(90+180) = 33%, e VPP depende da prevalência, não sendo a propriedade priorizada para escolher um teste de triagem. A opção que dá sensibilidade '33%' confunde o cálculo com o VPP.
Em um município, investiga-se um novo teste de rastreamento para determinada doença. A prevalência da doença na população estudada é muito baixa. Ao aplicar o teste, observa-se que, mantidas a sensibilidade e a especificidade, muitos resultados positivos ocorrem em pessoas sem a doença. Qual conceito epidemiológico explica melhor esse achado?
Valor preditivo positivo depende da prevalência: quanto menor a prevalência, menor o VPP, com mais falso-positivos entre os positivos, mesmo com sensibilidade e especificidade fixas. Sensibilidade e especificidade são propriedades intrínsecas do teste e não variam com a prevalência. A afirmação confunde os conceitos, e inverte a relação — baixa prevalência reduz o VPP, não o aumenta.
Um gestor de APS avalia dois testes de rastreamento para uma mesma condição na população do município. O teste A tem alta sensibilidade e menor especificidade; o teste B tem alta especificidade e menor sensibilidade. A condição rastreada é grave, tem tratamento eficaz quando detectada precocemente e o exame confirmatório subsequente é seguro e disponível. Para a etapa inicial de um programa de rastreamento populacional dessa condição, qual escolha é mais apropriada e por quê?
Na etapa de triagem de um rastreamento, prioriza-se sensibilidade para não deixar escapar doentes (minimizar falsos-negativos), sobretudo quando a doença é grave, o tratamento precoce é eficaz e há um teste confirmatório seguro que reclassifica os falsos-positivos gerados. Assim o teste A é o mais apropriado para o início (correta). Escolher o teste B prioriza especificidade/VPP, adequado à etapa confirmatória, não à triagem, e deixaria escapar doentes. Afirmar peso igual ignora a lógica sequencial de triagem e confirmação em programas de rastreamento.
Mulher, 45 anos, assintomática, participa de programa de rastreamento de uma doença cuja prevalência na população-alvo é de 2%. O teste utilizado tem sensibilidade de 90% e especificidade de 90%. A paciente recebe resultado POSITIVO e pergunta ao médico qual a probabilidade de realmente ter a doença. Com base nesses dados, qual é o valor preditivo positivo (VPP) aproximado desse resultado?
Correta: Numa coorte hipotética de 10.000 pessoas com prevalência 2%, há 200 doentes e 9.800 sadios. Com sensibilidade 90%, os verdadeiros-positivos são 0,90×200 = 180. Com especificidade 90%, os falso-positivos são 0,10×9.800 = 980. VPP = 180/(180+980) = 180/1.160 ≈ 15,5%. O conceito-chave é que, em doença de baixa prevalência, mesmo um teste com boa sensibilidade/especificidade gera muitos falso-positivos, derrubando o VPP. Erra VPP depende da prevalência e não é igual à sensibilidade (sensibilidade é P[teste+|doente], VPP é P[doente|teste+]). Erra: não há relação de soma entre especificidade e prevalência para o VPP. Erra: a igualdade sensibilidade=especificidade não implica VPP de 50%; o VPP depende fortemente da prevalência. Erra: alto VPN não garante alto VPP nem alta acurácia útil em rastreamento de doença rara.
Homem, 60 anos, em investigação para uma condição em que o objetivo do teste é RASTREAMENTO populacional: pretende-se identificar o maior número possível de doentes, aceitando-se posterior confirmação diagnóstica dos positivos por um segundo teste. O gestor dispõe de um exame com curva ROC conhecida e precisa escolher o ponto de corte adequado ao objetivo do rastreamento. Qual é a escolha de ponto de corte mais apropriada para essa finalidade?
Correta: Em rastreamento, o objetivo é não deixar escapar doentes (baixa taxa de falso-negativos), pois um teste confirmatório posterior filtra os falso-positivos. Portanto, escolhe-se um ponto de corte que privilegia a SENSIBILIDADE, mesmo à custa de mais falso-positivos e menor especificidade. Erra: privilegiar especificidade é a lógica de um teste CONFIRMATÓRIO (evitar rotular sadio como doente), não de rastreamento. Erra: igualar sensibilidade e especificidade é arbitrário e ignora o objetivo clínico do teste. Erra no rastreamento não se busca maximizar VPP; justamente aceita-se VPP menor e confirma-se depois. Erra no extremo inferior da curva (corte muito permissivo) a sensibilidade é alta, mas a razão de verossimilhança positiva NÃO é máxima ali — LR+ elevada ocorre em cortes mais restritivos; a afirmação inverte o conceito.
Em uma aula de epidemiologia, o professor apresenta a curva ROC (Receiver Operating Characteristic) de um teste diagnóstico e discute o significado da área sob a curva (AUC). Sobre a área sob a curva ROC, assinale a alternativa CORRETA.
Correta: a curva ROC plota sensibilidade (eixo Y) contra 1−especificidade (eixo X) para todos os pontos de corte possíveis. A AUC mede a capacidade discriminatória global do teste: AUC = 1,0 é o teste perfeito e AUC = 0,5 corresponde à linha diagonal do acaso (sem poder de discriminação, equivalente a jogar uma moeda). Quanto mais próxima de 1, melhor o teste. Erra: 0,5 é o pior desempenho útil (acaso), não o perfeito — o perfeito é 1,0. Erra: a AUC não representa prevalência; é independente da prevalência da doença. Erra: a AUC não equivale ao VPP (que depende da prevalência e do corte). Erra: a AUC justamente NÃO depende de um corte único — ela integra o desempenho ao longo de todos os cortes possíveis.
Um novo teste rápido para dengue foi avaliado em 1000 pacientes, usando a RT-PCR como padrão-ouro. Entre os 100 pacientes com dengue confirmada, o teste rápido foi positivo em 90. Entre os 900 pacientes sem a doença, o teste foi positivo em 20. Qual é a sensibilidade do teste rápido?
A sensibilidade é a proporção de doentes com teste positivo = VP/(VP+FN) = 90/(90+10) = 90%. 81,8% é o valor preditivo positivo [90/(90+20)]. 97,8% é a especificidade [880/(880+20)]. 98,9% é o valor preditivo negativo [880/(880+10)]. 97% é a acurácia global [(90+880)/1000]. Sensibilidade se calcula sempre na coluna dos doentes (verticalmente no padrão-ouro), não entre os testados positivos.
O mesmo teste rápido para dengue (sensibilidade 90%, especificidade 98%) passa a ser empregado em triagem populacional de uma região onde a prevalência da doença é muito baixa (0,5%), fora do período epidêmico. Comparado ao uso anterior em pacientes sintomáticos durante epidemia, o que se espera desse novo cenário?
Sensibilidade e especificidade são propriedades intrínsecas do teste e não variam com a prevalência; já os valores preditivos dependem dela. Com prevalência muito baixa, a proporção de falsos-positivos entre os positivos cresce e o VPP cai. Sensibilidade não depende da prevalência. Ao contrário, com prevalência baixa o VPN tende a subir (mais verdadeiros-negativos). Especificidade não muda com a prevalência. O VPP diminui, não aumenta, quando a prevalência cai — é o erro clássico de triagem em população de baixo risco.
Na validação de um marcador sérico contínuo para triagem de um câncer potencialmente curável, o objetivo prioritário é reduzir ao máximo o número de casos não detectados. Analisando a curva ROC do marcador, a equipe decide deslocar o ponto de corte para um valor mais baixo. Qual é a consequência esperada dessa mudança de cutoff?
Baixar o ponto de corte classifica mais indivíduos como positivos: capta mais doentes (maior sensibilidade, menos falsos-negativos), mas às custas de mais falsos-positivos e menor especificidade — o trade-off da curva ROC. Para triagem de doença grave e tratável, prioriza-se alta sensibilidade, justamente o que o corte mais baixo oferece. Aumentar sensibilidade e especificidade ao mesmo tempo é impossível apenas movendo o cutoff; há sempre compromisso. Aumentar a especificidade e reduzir os falsos-positivos ocorreria elevando o corte, não baixando. Reduzir a sensibilidade e aumentar os falsos-negativos descreve o efeito oposto, também de um corte mais alto. A AUC é propriedade global do teste, pois integra todos os cortes, e não muda ao escolher um único ponto de corte.
Em um estudo de validação de um teste rápido para detecção do antígeno NS1 da dengue, 500 pacientes com síndrome febril aguda foram testados e comparados ao RT-PCR (padrão-ouro). Dos 200 pacientes com dengue confirmada pelo RT-PCR, 160 tiveram teste rápido positivo. Entre os 300 pacientes sem a doença, 30 tiveram teste rápido positivo. Qual é a sensibilidade do teste rápido?
Montando a tabela 2x2: verdadeiros-positivos (VP) = 160, falsos-negativos (FN) = 40 (200 doentes); falsos-positivos (FP) = 30, verdadeiros-negativos (VN) = 270 (300 sadios). Sensibilidade = VP/(VP+FN) = 160/200 = 80% (correta) — mede a capacidade de detectar quem TEM a doença. 90% é a especificidade = VN/(VN+FP) = 270/300, capacidade de identificar quem NÃO tem a doença. 84% é o valor preditivo positivo = VP/(VP+FP) = 160/190 = 84,2%, probabilidade de doença dado teste positivo. 87% é o valor preditivo negativo = VN/(VN+FN) = 270/310 = 87,1%. 40% não corresponde a nenhum parâmetro (confusão com a fração 200/500 ou troca de coluna). O ponto-chave: sensibilidade e especificidade têm como denominador o total de doentes e de sadios, respectivamente — nunca a coluna do resultado do teste.
Um teste sorológico para uma infecção rara apresenta sensibilidade de 99% e especificidade de 99%. Uma secretaria de saúde decide usá-lo em rastreamento populacional de indivíduos assintomáticos, em uma população na qual a prevalência da infecção é de 0,1% (1 em cada 1.000 pessoas). Um indivíduo assintomático testa positivo. Qual é a probabilidade aproximada de ele realmente estar infectado?
A pergunta é sobre o valor preditivo positivo (VPP), que depende da prevalência. Simulando 100.000 pessoas com prevalência de 0,1%: 100 infectados e 99.900 sadios. Com sensibilidade 99% → 99 verdadeiros-positivos (e 1 falso-negativo); com especificidade 99% → 1% dos 99.900 sadios = 999 falsos-positivos. VPP = VP/(VP+FP) = 99/(99+999) = 99/1098 = 9,0% (correta). Ou seja, mesmo com um teste 'excelente', em baixa prevalência a maioria dos positivos é falso-positivo. 99% confunde VPP com a sensibilidade/especificidade (propriedades intrínsecas, independentes da prevalência). 90% aproxima-se do complemento e ignora o excesso de falsos-positivos. 50% assumiria erroneamente prevalência próxima de 50% (onde o VPP se aproxima da especificidade). 0,1% é a própria prevalência (probabilidade pré-teste), não a pós-teste. Este é o fundamento bayesiano contra rastrear doenças raras em assintomáticos com testes isolados.
Em uma campanha de rastreamento realizada em uma Unidade Básica de Saúde, um teste rápido foi aplicado a 1.000 usuários adultos. Posteriormente, todos foram avaliados pelo padrão-ouro, que confirmou a doença em 100 pessoas. Entre os 100 indivíduos comprovadamente doentes, 90 apresentaram teste positivo. Entre os 900 indivíduos sem a doença, 180 tiveram teste positivo. A equipe deseja saber, entre os usuários que receberam resultado positivo no teste rápido, qual a proporção que realmente tem a doença, para orientar o aconselhamento. Com base nesses dados, qual é o valor preditivo positivo do teste nessa população?
O valor preditivo positivo (VPP) = verdadeiros-positivos / total de positivos = 90 / (90 + 180) = 90/270 ≈ 33%. Os 90% correspondem à sensibilidade (90/100), não ao VPP. Os 80% correspondem à especificidade (720/900). Os ~99% correspondem ao valor preditivo negativo (720/730). Como a prevalência é baixa (10%), o VPP cai mesmo com boa sensibilidade, pois há muitos falsos-positivos.
Uma gestante de 24 anos comparece à Unidade Básica de Saúde para a primeira consulta de pré-natal. Seguindo o protocolo do Ministério da Saúde, a enfermeira realiza os testes rápidos de triagem para sífilis e HIV. A médica explica à equipe que, para um teste de rastreamento de doenças graves e tratáveis em população assintomática, o objetivo prioritário é não deixar passar despercebido nenhum caso verdadeiro, minimizando os resultados falso-negativos, ainda que isso possa gerar alguns resultados falso-positivos que serão posteriormente confirmados por teste complementar. Qual propriedade do teste de triagem deve ser priorizada para cumprir esse objetivo?
Testes de rastreamento de doenças graves e tratáveis priorizam alta sensibilidade, pois minimizam falsos-negativos (não perdem doentes); um teste sensível, quando negativo, afasta a doença. A alta especificidade é desejável no teste confirmatório, para evitar falsos-positivos. O valor preditivo positivo depende da prevalência e não é a propriedade priorizada na triagem. Baixa razão de verossimilhança positiva indicaria teste ruim para confirmar doença.
Em uma UPA, um médico avalia a acurácia de um escore clínico para prever desfecho em pacientes com determinada condição, usando uma curva ROC. O ponto de corte atual do escore apresenta sensibilidade de 70% e especificidade de 85%. Preocupado em não deixar de identificar pacientes de risco (reduzir falsos-negativos), a equipe decide reduzir o valor de corte do escore, tornando-o positivo mais facilmente. O médico questiona quais serão as consequências esperadas dessa mudança de ponto de corte sobre o desempenho do teste. Considerando as propriedades da curva ROC, qual é a consequência esperada ao reduzir o ponto de corte?
Na curva ROC há um trade-off: reduzir o ponto de corte torna o teste positivo mais facilmente, captando mais doentes (aumenta a sensibilidade) às custas de mais falsos-positivos (reduz a especificidade). Não é possível aumentar as duas simultaneamente apenas movendo o corte — isso exigiria um teste melhor (maior área sob a curva). Reduzir sensibilidade e aumentar especificidade ocorreria ao elevar o corte. A mudança de corte necessariamente altera as duas propriedades de forma inversa.
Uma equipe de Saúde da Família de um município do interior organiza campanha de testagem rápida para HIV dirigida à população geral adscrita ao território, cuja prevalência estimada da infecção é de 1%. O teste rápido utilizado, fornecido pelo Ministério da Saúde, apresenta sensibilidade de 99% e especificidade de 90%. Ao final da campanha, 10.000 pessoas foram testadas. O médico da equipe é procurado por vários usuários com resultado reagente, angustiados, e precisa orientar a equipe de enfermagem sobre a conduta e sobre o significado do resultado antes de qualquer comunicação diagnóstica. Considerando as características do teste e o cenário epidemiológico descrito, qual é a interpretação correta?
Com prevalência de 1% em 10.000 testados há 100 infectados e 9.900 não infectados. Sensibilidade de 99% gera 99 verdadeiro-positivos; especificidade de 90% gera 10% de 9.900 = 990 falso-positivos. VPP = 99/(99+990) ≈ 9%. O valor preditivo positivo depende diretamente da prevalência — quanto menor a prevalência, menor o VPP — e por isso o fluxograma de testagem do Ministério da Saúde exige teste complementar (segundo teste rápido de fabricante diferente ou teste laboratorial) antes de qualquer diagnóstico. A primeira alternativa confunde VPP com sensibilidade (parâmetro intrínseco ao teste, calculado entre os doentes) e comunicaria diagnóstico a uma maioria de pessoas não infectadas. A terceira confunde VPP com especificidade e restringe a confirmação por critério de risco, o que não é previsto. A quarta inverte o raciocínio: em baixa prevalência com sensibilidade alta o VPN é elevado (≈ 99,9%), sendo o resultado não reagente o mais confiável.
Em um centro de saúde, um médico participa de estudo de validação de um novo teste imunocromatográfico para diagnóstico de leishmaniose visceral. Foram avaliados 200 indivíduos, todos submetidos ao novo teste e ao exame padrão-ouro. O padrão-ouro confirmou a doença em 50 pessoas e a excluiu em 150. Entre os 50 doentes, o novo teste foi positivo em 45. Entre os 150 sem a doença, o novo teste foi positivo em 30. Com base exclusivamente nesses dados, quais são, respectivamente, a sensibilidade e a especificidade do novo teste?
Sensibilidade é a proporção de doentes (definidos pelo padrão-ouro) com teste positivo: 45/50 = 90%. Especificidade é a proporção de não doentes com teste negativo: dos 150 sem a doença, 30 foram positivos (falso-positivos) e 120 negativos, logo 120/150 = 80%. As demais alternativas resultam de cálculos com denominadores incorretos — por exemplo, usar o total de testados (45/100 = 45%) ou misturar as colunas da tabela 2x2. A regra é que sensibilidade e especificidade se calculam sempre na vertical, entre doentes e não doentes definidos pelo padrão-ouro, enquanto os valores preditivos se calculam na horizontal, entre testados positivos e negativos.
Um médico de família coordena o rastreamento de diabetes melito em sua área de abrangência utilizando glicemia de jejum. O grupo de trabalho municipal, preocupado com os casos não detectados, propõe reduzir o ponto de corte para encaminhamento a exame confirmatório de 126 mg/dL para 110 mg/dL, mantendo o mesmo exame, o mesmo laboratório e a mesma população-alvo. A curva ROC do teste, construída previamente com todos os pontos de corte possíveis contra o padrão-ouro, apresenta área sob a curva de 0,88. Um residente pergunta qual será o efeito dessa mudança sobre o desempenho do rastreamento. Qual é a resposta correta?
Reduzir o ponto de corte de um teste quantitativo torna o critério de positividade menos exigente: mais doentes são captados (mais verdadeiro-positivos, maior sensibilidade), mas também mais não doentes são rotulados como positivos (mais falso-positivos, menor especificidade). Esse trade-off é exatamente o que a curva ROC representa — cada ponto de corte é um ponto da curva. A área sob a curva resume o desempenho do teste em todos os pontos de corte e, portanto, não muda quando se escolhe outro corte; só mudaria com outro teste ou outro método de medida. A primeira alternativa inverte o sentido do trade-off e ainda supõe alteração da AUC. A segunda confunde sensibilidade e especificidade (intrínsecas ao teste) com valores preditivos, estes sim dependentes da prevalência. A quarta viola o trade-off: em um mesmo teste não se aumentam os dois parâmetros ao mesmo tempo apenas deslocando o corte.
Durante campanha de testagem em uma unidade básica de saúde de município cuja prevalência estimada de infecção pelo HIV na população geral é de 0,1%, um homem de 34 anos, assintomático, sem histórico de infecções sexualmente transmissíveis, sem uso de drogas injetáveis e em relacionamento estável há oito anos, aceita realizar teste rápido de triagem por curiosidade. O teste utilizado tem sensibilidade de 99% e especificidade de 98%. O resultado é reagente. O paciente, muito angustiado, pergunta se já está confirmado que tem a doença. O exame físico é inteiramente normal e ele nega qualquer exposição de risco nos últimos anos. Quais são, respectivamente, a interpretação correta do resultado e a conduta?
A sensibilidade e a especificidade são propriedades do teste e não mudam com a prevalência, mas os valores preditivos, sim. Aplicando os dados a 100.000 pessoas com prevalência de 0,1%: 100 infectados, dos quais 99 testam reagentes (verdadeiro-positivos); entre os 99.900 não infectados, 2% resultam reagentes, ou seja, 1.998 falsos-positivos. O valor preditivo positivo é 99/2.097 ≈ 4,7% — a maioria dos reagentes é falso-positiva. Por isso o fluxograma do Ministério da Saúde exige um segundo teste rápido de fabricante/plataforma diferente (TR2) para concluir o diagnóstico (correta). A alternativa que invoca a sensibilidade de 99% confunde sensibilidade com valor preditivo positivo e comunica diagnóstico não confirmado. Desconsiderar o resultado por ausência de fatores de risco é inaceitável: todo teste reagente deve ser investigado, e janela imunológica geraria falso-negativo, não falso-positivo. Afirmar que 2% dos reagentes são falsos-positivos inverte a definição de especificidade (2% dos NÃO infectados testam positivo, não 2% dos positivos) e ignora o efeito da prevalência.
A coordenação de atenção primária de um município planeja rastreamento oportunístico de diabetes melito em adultos com fatores de risco, usando glicemia capilar de jejum nas unidades de saúde da família. Todos os indivíduos com triagem positiva serão encaminhados para confirmação com exame laboratorial (glicemia plasmática de jejum ou HbA1c), padrão de referência do estudo. A curva ROC construída mostrou área sob a curva de 0,88. Dois pontos de corte foram avaliados: 100 mg/dL, com sensibilidade de 92% e especificidade de 60%; e 126 mg/dL, com sensibilidade de 55% e especificidade de 97%. O município dispõe de rede laboratorial suficiente para absorver os encaminhados. Qual ponto de corte deve ser adotado e por quê?
Na curva ROC, deslocar o ponto de corte troca sensibilidade por especificidade. A escolha depende da finalidade: em RASTREAMENTO, cujo objetivo é não deixar escapar doentes e cujo resultado positivo será obrigatoriamente confirmado por teste de referência, prioriza-se a SENSIBILIDADE — logo, 100 mg/dL (correta). Os falsos-positivos gerados pela especificidade de 60% são um custo aceitável, pois serão eliminados na etapa confirmatória laboratorial, que o município tem capacidade de absorver; já o falso-negativo (45% dos doentes com o corte de 126 mg/dL) sai do sistema sem diagnóstico. Escolher 126 mg/dL inverte a lógica: alta especificidade é desejável no teste CONFIRMATÓRIO, não no de triagem. Área sob a curva de 0,88 indica boa acurácia discriminatória (0,8–0,9), não desempenho insuficiente — não há corte de 0,90 que invalide o teste. A última alternativa contém erro conceitual: valor preditivo positivo NÃO é propriedade intrínseca do teste e varia com a prevalência; a curva ROC relaciona sensibilidade e 1−especificidade, não valores preditivos.
Em uma campanha de testagem realizada em uma Unidade Básica de Saúde de um município de baixa endemicidade, aplica-se um teste rápido para HIV com sensibilidade de 99,5% e especificidade de 99,0%. A prevalência estimada de infecção pelo HIV na população testada é de 0,1%. Um usuário assintomático, sem exposição de risco relatada, apresenta resultado reagente no primeiro teste. Considerando apenas os parâmetros apresentados, qual é o valor preditivo positivo aproximado desse resultado nessa população?
Correta: ~9%. Em 100.000 testados com prevalência de 0,1%, há 100 infectados (99,5 verdadeiros-positivos, pela sensibilidade de 99,5%) e 99.900 não infectados, dos quais 1% resulta falso-positivo (999). VPP = 99,5 / (99,5 + 999) ≈ 9%. Por isso o fluxograma do Ministério da Saúde exige um segundo teste para definir o diagnóstico. 'Aproximadamente 50%' corresponderia a uma prevalência bem maior (~1%), não à referida. 'Aproximadamente 90%' confunde VPP com a sensibilidade do teste. 'Aproximadamente 99,5%' repete a sensibilidade: o VPP depende da prevalência, e em cenário de baixa prevalência os falsos-positivos superam os verdadeiros-positivos.
A coordenação de saúde mental de um município avalia dois instrumentos de rastreamento de depressão para uso na Atenção Primária, comparando-os com a entrevista diagnóstica estruturada como padrão-ouro. A curva ROC do instrumento A tem área sob a curva (AUC) de 0,91 e a do instrumento B, de 0,67. Pretende-se rastrear a população adscrita, encaminhando os positivos para avaliação médica. Qual é a interpretação correta desses achados?
Correta: a AUC mede a capacidade discriminatória global do teste em todos os pontos de corte; 0,91 (bom/excelente) supera 0,67 (fraco). Em rastreamento na APS, escolhe-se o ponto de corte que privilegie a sensibilidade, aceitando mais falsos-positivos, pois estes serão filtrados na avaliação médica subsequente. 'Instrumento B' inverte a lógica do rastreamento: menor AUC significa pior discriminação, e reduzir encaminhamentos à custa de perder casos é inadequado nessa etapa. 'A AUC aumentará com a prevalência' está errado: a AUC deriva de sensibilidade e especificidade, propriedades intrínsecas do teste, independentes da prevalência (quem depende dela são os valores preditivos). 'AUC = 91% terão depressão' confunde AUC com valor preditivo positivo.
A vigilância epidemiológica de um município avaliou o desempenho de um teste rápido para dengue tendo a RT-PCR como padrão-ouro. Entre 200 pessoas com dengue confirmada pela RT-PCR, o teste rápido foi positivo em 180. Entre 300 pessoas sem dengue pela RT-PCR, o teste rápido foi negativo em 285. Qual é a sensibilidade do teste rápido nessa avaliação?
Correta: 90%. Sensibilidade = verdadeiros-positivos / total de doentes = 180/200 = 90%. É a capacidade do teste de detectar quem tem a doença. '95%' é a especificidade (285/300 = 95%), ou seja, a proporção de negativos corretos entre os não doentes. '80%' e '60%' não correspondem a nenhuma razão obtida a partir da tabela 2x2 apresentada.
Em uma Unidade Básica de Saúde, um teste de rastreamento para determinada doença foi aplicado em 1.000 pessoas. Entre as 200 que realmente tinham a doença (confirmadas por padrão-ouro), o teste foi positivo em 180. Entre as 800 sem a doença, o teste foi positivo em 160. A equipe deseja avaliar a capacidade do teste de identificar corretamente os indivíduos que têm a doença. Qual é a sensibilidade desse teste?
Sensibilidade = verdadeiros-positivos / total de doentes = 180/200 = 90% (capacidade de detectar quem tem a doença). 80% corresponde à especificidade (640 verdadeiros-negativos / 800 sadios). 53% é o valor preditivo positivo (180 / 340 positivos). 97% é o valor preditivo negativo (640 / 660 negativos).
Em uma campanha na atenção primária, um teste rápido com sensibilidade de 99% e especificidade de 99% é aplicado para rastrear uma infecção cuja prevalência na população geral rastreada é de cerca de 0,1%. Um homem de 30 anos, assintomático e sem fatores de risco, recebe resultado positivo. Considerando as características do teste e o cenário epidemiológico, qual é a conduta mais adequada antes de comunicar um diagnóstico definitivo?
Mesmo com sensibilidade e especificidade altas, em prevalência muito baixa a proporção de falso-positivos supera a de verdadeiros-positivos, derrubando o valor preditivo positivo; o correto é confirmar com teste de metodologia diferente antes de diagnosticar. Comunicar de imediato ignora o efeito da prevalência sobre o VPP. Repetir o mesmo teste não corrige seu erro sistemático. O teste mantém validade em assintomáticos — o problema é interpretativo, não de invalidade.
Uma gestora de UBS analisa a curva ROC de um teste quantitativo usado no rastreamento de uma doença. Preocupada em não deixar casos passarem despercebidos (minimizar falsos-negativos), ela decide adotar um ponto de corte mais baixo do que o habitualmente recomendado para diagnóstico. Em relação ao desempenho do teste com esse novo ponto de corte, o que se espera?
Reduzir o ponto de corte classifica mais pessoas como positivas: capta mais doentes (maior sensibilidade), mas também rotula mais sadios como positivos (menor especificidade, mais falso-positivos) — o trade-off descrito pela curva ROC. Sensibilidade e especificidade não sobem juntas ao mover o corte. Corte mais baixo não reduz a sensibilidade. E o ponto de corte é justamente o que determina o par sensibilidade/especificidade ao longo da curva.
Durante uma epidemia de dengue em um município do Sudeste, a Vigilância Epidemiológica aplica o teste rápido NS1 em 1.000 pacientes sintomáticos atendidos na rede de atenção básica. Sabe-se que, nesse cenário, a prevalência real da doença entre os sintomáticos é de 30%. O teste NS1 utilizado apresenta sensibilidade de 90% e especificidade de 85%. Considerando exclusivamente esses dados e assumindo distribuição conforme os parâmetros informados, assinale o valor preditivo positivo (VPP) aproximado do teste nessa população.
Com 1.000 pacientes e prevalência de 30%, há 300 doentes e 700 sadios. Verdadeiros-positivos = 300 x 0,90 = 270; falsos-positivos = 700 x 0,15 = 105. VPP = 270 / (270 + 105) = 270/375 ≈ 72% (correta). 90% é a sensibilidade e 85% a especificidade, parâmetros intrínsecos ao teste, não o VPP. 95% corresponde ao valor preditivo negativo [TN 595 / (595 + FN 30)].
Homem de 42 anos, previamente hígido, procura a UPA com dor torácica pleurítica de início há 6 horas, sem dispneia importante, sem edema ou dor em membros inferiores, sem imobilização recente, cirurgia ou neoplasia. Ao aplicar o escore de Wells, o médico classifica o paciente como de baixa probabilidade pré-teste para tromboembolismo pulmonar (TEP). Solicita então a dosagem de D-dímero, que retorna negativo (abaixo do ponto de corte). Considerando as propriedades desse exame nesse contexto, assinale a conduta mais adequada.
O D-dímero é um teste de alta sensibilidade e baixa especificidade; um resultado NEGATIVO em paciente com baixa probabilidade pré-teste confere alto valor preditivo negativo, permitindo excluir TEP sem imagem (regra SnNout — teste sensível com resultado negativo afasta a doença) — correta. Solicitar angio-TC é desnecessário e expõe a contraste e radiação diante de um exame que já descartou a hipótese. Anticoagular seria tratar doença excluída. Repetir o D-dímero não agrega, pois o resultado negativo já é conclusivo nesse estrato de risco.
Uma equipe de Saúde da Família planeja um programa de rastreamento de diabetes mellitus na comunidade utilizando a glicemia de jejum. Com o objetivo de captar o maior número possível de casos e reduzir a chance de deixar de identificar portadores da doença, a coordenação propõe reduzir o ponto de corte adotado para considerar o teste positivo, de 126 mg/dL para 110 mg/dL, encaminhando à confirmação diagnóstica todos os indivíduos acima desse novo valor. Assinale a alternativa que descreve corretamente o efeito esperado dessa mudança sobre o desempenho do teste.
Deslocar o ponto de corte para um valor mais baixo classifica mais pessoas como positivas: capta mais doentes (sobe a sensibilidade), mas também rotula mais sadios como positivos (cai a especificidade e aumentam os falso-positivos) — é exatamente o trade-off representado ao caminhar sobre a curva ROC. Supor ganho de especificidade com redução dos falso-positivos inverte o sentido dessa troca. A mudança de corte altera sim sensibilidade e especificidade, não apenas o valor preditivo positivo. E a área sob a curva ROC é propriedade global do teste, que não muda ao se escolher um corte diferente.
Em um município da região Norte, a coordenação de vigilância implanta busca ativa de infecção pelo HIV com teste rápido em população geral assintomática, na qual a prevalência estimada da infecção é de 1%. O teste utilizado tem sensibilidade de 99% e especificidade de 98%, segundo a bula e estudos de validação nacionais. Foram testadas 10.000 pessoas. Um gestor questiona quantos dos indivíduos com resultado reagente realmente têm a infecção, antes da etapa confirmatória. Considerando exclusivamente os dados apresentados, o valor preditivo positivo do teste nessa população é de:
Montando a tabela 2x2 para 10.000 testados com prevalência de 1%: 100 infectados e 9.900 não infectados. Sensibilidade 99% gera 99 verdadeiros-positivos; especificidade 98% gera 9.900 x 0,02 = 198 falso-positivos. VPP = 99/(99+198) = 33,3% — daí a regra de que, em baixa prevalência, mesmo um teste acurado produz maioria de reagentes falsos, o que justifica o fluxograma confirmatório do Ministério da Saúde. A alternativa de 98% confunde valor preditivo (que depende da prevalência) com especificidade (que não depende). 67% inverte a razão (corresponderia à proporção de falso-positivos entre os reagentes) e 50% seria o resultado apenas se o número de falso-positivos igualasse o de verdadeiros-positivos, o que exigiria especificidade de 99%.
Uma UPA utiliza um escore de alerta precoce para acionar o protocolo de sepse, com ponto de corte de 3 pontos. Após auditoria mostrar óbitos em pacientes que pontuaram 2, a comissão decide reduzir o ponto de corte para 2 pontos, mantendo o mesmo escore e a mesma população atendida. A equipe de qualidade é solicitada a antecipar o impacto dessa mudança sobre o desempenho diagnóstico da ferramenta. Assinale a alternativa que descreve corretamente o efeito esperado dessa redução do ponto de corte.
Deslocar o ponto de corte apenas move a posição do teste ao longo da mesma curva ROC: com corte mais baixo, mais pacientes são classificados como positivos, elevando verdadeiros-positivos (maior sensibilidade) e também falso-positivos (menor especificidade); o VPN sobe e o VPP cai. A área sob a curva ROC é uma propriedade global do escore, independente do corte escolhido, e por isso não se altera — o que invalida qualquer resposta que descreva aumento da AUC. Ganhar sensibilidade e especificidade ao mesmo tempo só ocorreria com um teste diferente/melhor, não com mudança de corte. A alternativa de queda de sensibilidade com ganho de especificidade descreve o efeito de ELEVAR o corte, e afirmar ganho de valor preditivo positivo contraria a definição de VPP, que diminui quando aumentam os falso-positivos.
Em estudo de validação em maternidade pública, 1.000 gestantes do primeiro trimestre foram submetidas ao teste rápido treponêmico para sífilis e, todas elas, ao algoritmo laboratorial de referência. O padrão-ouro identificou 50 gestantes com sífilis, das quais 48 tiveram teste rápido reagente. Entre as 950 sem a infecção, 19 tiveram teste rápido reagente. A equipe pretende agora aplicar o mesmo teste em serviço de referência para gestantes de alto risco, onde a prevalência é cerca de quatro vezes maior. A especificidade do teste no estudo e o comportamento esperado do valor preditivo positivo no novo cenário são, respectivamente:
Especificidade = verdadeiros-negativos/total de não doentes = (950-19)/950 = 931/950 = 98%. Os 96% correspondem à sensibilidade (48/50) e os 72% ao valor preditivo positivo do próprio estudo (48/67), sendo distratores que trocam a medida solicitada. Como sensibilidade e especificidade são propriedades do teste e independem da prevalência, ao levá-lo a uma população com prevalência quatro vezes maior o VPP aumenta (maior proporção de reagentes verdadeiros) e o VPN diminui — daí a lógica de priorizar testagem em populações de maior risco. A alternativa que afirma manutenção do VPP confunde valor preditivo com acurácia intrínseca, e a que prevê queda do VPP inverte a relação com a prevalência.
Para avaliar um novo teste rápido de rastreamento de uma infecção crônica, uma equipe de vigilância aplicou o teste em 1.000 pessoas de uma comunidade e comparou os resultados com o padrão-ouro. Entre os 100 indivíduos verdadeiramente doentes, o teste foi positivo em 90 e negativo em 10. Entre os 900 indivíduos sem a doença, o teste foi positivo em 90 e negativo em 810. O gestor deseja saber qual a probabilidade de um morador com teste positivo realmente ter a infecção, para dimensionar a demanda de exames confirmatórios. Assinale a alternativa que apresenta esse valor.
A probabilidade de doença diante de um teste positivo é o valor preditivo positivo: VP/(VP+FP) = 90/(90+90) = 50%. Note que sensibilidade e especificidade são ambas de 90%, mas a prevalência de 10% derruba o VPP — daí a necessidade de teste confirmatório. É a sensibilidade (90/100) e também a especificidade (810/900), não o VPP. É o valor preditivo negativo (810/820 = 98,8%). É a prevalência da infecção na comunidade (100/1.000), que seria a probabilidade pré-teste, e não a pós-teste.
Um programa municipal utiliza um exame quantitativo para rastreamento de uma doença grave, porém tratável quando detectada precocemente. Atualmente adota-se o ponto de corte de 10 unidades para considerar o exame alterado. Preocupado com o número de casos perdidos, o coordenador propõe reduzir o ponto de corte para 6 unidades, mantendo o mesmo exame, o mesmo laboratório e a mesma população-alvo. A equipe de epidemiologia é consultada sobre as consequências dessa mudança nas propriedades do teste. Assinale a alternativa que descreve corretamente o que se espera após a redução do ponto de corte.
Baixar o ponto de corte de um teste quantitativo torna-o mais 'frouxo': mais doentes são captados (sobe a sensibilidade e, com ela, o valor preditivo negativo), mas também mais sadios são rotulados como positivos (cai a especificidade e o valor preditivo positivo). A curva ROC representa todos os pontos de corte possíveis do mesmo teste; mudar o corte apenas desloca a posição sobre a curva, sem alterar a área sob ela, que é propriedade intrínseca do exame. Subir sensibilidade e especificidade ao mesmo tempo é impossível: elas têm relação inversa quando se move o corte. Aumentar a especificidade e o valor preditivo positivo descreve o efeito de elevar, não de reduzir, o ponto de corte. Dizer que a especificidade depende da prevalência erra o conceito — quem depende da prevalência são os valores preditivos.
Sobre a curva ROC e a área sob a curva de um teste diagnóstico com resultado quantitativo, é correto afirmar que:
A curva ROC plota a sensibilidade (fração de verdadeiros-positivos) no eixo vertical contra 1 − especificidade (fração de falsos-positivos) no eixo horizontal, varrendo todos os pontos de corte possíveis; cada ponto da curva é um limiar de positividade. Inverter os eixos, pondo especificidade na vertical e sensibilidade na horizontal, descreve outro gráfico. A área sob a curva resume a curva inteira num número entre 0,5 e 1 e corresponde à probabilidade de que, sorteando ao acaso um doente e um não-doente, o doente apresente o valor mais alto do teste — não é a proporção de pacientes corretamente classificados num corte específico. Área de 0,5 é a diagonal do acaso, ou seja, teste sem aplicabilidade clínica, e não 'metade dos pacientes bem classificados'. E a curva não dispensa a escolha do corte: ela mostra o preço de cada escolha, que depende da intenção do teste.
Um mesmo teste diagnóstico é aplicado, com o mesmo ponto de corte e no mesmo perfil de paciente, em dois serviços que diferem apenas na prevalência da doença. Qual das medidas abaixo tem o MESMO valor nos dois serviços?
A razão de verossimilhança positiva é sensibilidade/(1 − especificidade): é construída apenas com medidas condicionadas ao estado de doença, calculadas dentro de cada coluna da tabela 2×2, e por isso independe do tamanho relativo das colunas — ou seja, da prevalência. Valor preditivo positivo e negativo dependem da prevalência por definição, porque dividem pelo total de uma linha, que mistura doentes e não-doentes. A acurácia também depende, porque é uma média de sensibilidade e especificidade ponderada pelo tamanho de cada coluna. E a proporção de positivos entre todos os testados, (a+b)/N, muda diretamente com a prevalência, já que os verdadeiros-positivos aumentam quando há mais doentes.
Em uma triagem, dois testes são aplicados simultaneamente e a amostra é considerada positiva quando pelo menos um deles for reagente. Comparado ao uso isolado do melhor dos dois testes, esse arranjo:
O arranjo descrito é o teste em paralelo, cujo critério de positividade é 'ou': basta um resultado reagente para o conjunto ser positivo. Ele captura todos os casos que qualquer um dos testes detectaria, elevando a sensibilidade acima da do teste mais sensível isolado — mas incorpora também os falsos-positivos de cada um deles, derrubando a especificidade do conjunto. O arranjo oposto é o teste em série, com critério 'e' (positivo apenas se ambos forem positivos), que eleva a especificidade acima da do teste mais específico isolado e reduz a sensibilidade. É exatamente por isso que programas de rastreamento usam triagem sensível na frente e confirmação específica atrás.
Um teste sorológico para uma parasitose tem sensibilidade de 90% e especificidade de 90%, medidas em um estudo de acurácia bem conduzido, com série consecutiva de pacientes com suspeita clínica. O teste vinha sendo usado em um ambulatório de referência, onde a prevalência da doença entre os encaminhados é de 30%. A secretaria municipal decide adotar o mesmo teste, com o mesmo ponto de corte, em um inquérito populacional em área onde a prevalência é de 1%. Comparando o desempenho no inquérito com o desempenho no ambulatório, é correto afirmar que:
Sensibilidade e especificidade são proporções calculadas dentro de uma coluna só da tabela 2×2 — a dos doentes e a dos não-doentes, respectivamente — e não se alteram quando muda apenas a prevalência. As contas: no ambulatório, em 1.000 pacientes, 300 doentes geram 270 verdadeiros-positivos e 700 não-doentes geram 70 falsos-positivos, logo VPP = 270/340 = 79%; no inquérito, em 10.000 pessoas, 100 doentes geram 90 verdadeiros-positivos e 9.900 não-doentes geram 990 falsos-positivos, logo VPP = 90/1.080 = 8,3%. O VPN sobe de 630/660 = 95% para 8.910/8.920 = 99,9%. Dizer que sensibilidade e especificidade caem descreve viés de espectro, que exigiria mudança no perfil e na gravidade dos pacientes, e não apenas na prevalência. Dizer que a especificidade cai para acomodar falsos-positivos confunde o número absoluto de falsos-positivos, que de fato cresce, com a proporção dentro da coluna dos sadios, que não muda. Afirmar que o valor preditivo positivo se mantém ignora que ele depende justamente da prevalência. E fazer a acurácia global cair para 8% confunde acurácia com valor preditivo: ela continua 90% nos dois cenários — o que é justamente o motivo de enganar quando a doença é rara.
Em um estudo de acurácia, 500 pessoas com suspeita de perda auditiva foram submetidas a um teste audiométrico e ao padrão de referência. Das 300 pessoas com o diagnóstico confirmado, 270 tiveram teste positivo. Das 200 pessoas sem o diagnóstico, 60 tiveram teste positivo. A sensibilidade e a especificidade do teste audiométrico são, respectivamente:
Sensibilidade divide pelo total da coluna dos doentes: 270/300 = 90%. Especificidade divide pelo total da coluna dos não-doentes: como 60 das 200 pessoas sem a doença testaram positivo, sobram 140 verdadeiros-negativos, e 140/200 = 70%. O valor de 82% que aparece em três das opções é o valor preditivo positivo — 270/(270+60) = 270/330 = 81,8% —, que divide pelo total da LINHA dos positivos e responde a uma pergunta diferente: dado um teste positivo, qual a probabilidade de a pessoa ter a doença. E o par 70% e 90% simplesmente inverte sensibilidade e especificidade.
Um teste de rastreamento tem sensibilidade de 80% e especificidade de 95%. Ele será aplicado a uma população de 10.000 pessoas na qual a prevalência da doença é de 2%. Qual é o valor preditivo positivo esperado?
Com prevalência de 2%, 200 das 10.000 pessoas têm a doença e 9.800 não têm. A sensibilidade de 80% sobre 200 doentes dá 160 verdadeiros-positivos; a especificidade de 95% sobre 9.800 sadios deixa 5% de falsos-positivos, ou seja, 490. Logo VPP = 160/(160+490) = 160/650 = 24,6%. Pela rota das chances o resultado é idêntico: chance pré-teste = 0,02/0,98 = 0,0204; RV+ = 0,80/0,05 = 16; chance pós-teste = 0,0204 × 16 = 0,326; probabilidade = 0,326/1,326 = 24,6%. Responder 80% ou 95% apenas repete a sensibilidade e a especificidade, que não respondem à pergunta feita. Responder 99% dá aproximadamente o valor preditivo negativo (9.310/9.350 = 99,6%). E 2% devolve a própria prevalência, sem aplicar o teste.
Um estudo avaliou um novo marcador sérico para câncer de próstata. Todos os 1.200 homens incluídos realizaram o marcador, mas apenas aqueles com resultado acima do ponto de corte foram encaminhados à biópsia prostática, o padrão de referência; os demais foram classificados como sem a doença, sem verificação. Considerando que existam biópsias positivas, qual é o problema desse procedimento e seu efeito sobre as estimativas aparentes?
Com todos os testes negativos classificados como não doentes, nenhum falso negativo aparece na tabela. Havendo verdadeiros positivos, a sensibilidade calculada é TP/(TP+0)=100%. Se houver falsos negativos reais, sua contagem indevida como verdadeiros negativos também pode aumentar TN/(TN+FP), superestimando a especificidade. Isso difere de simplesmente excluir pacientes não verificados da análise, outro desenho de viés de verificação. O desempenho real permanece desconhecido sem referência adequada nos negativos. Referência metodológica: STARD 2015, BMJ h5527; efeito demonstrado pela tabela 2×2 descrita no enunciado.
Dois radiologistas leram, de forma independente, 100 radiografias de tórax e as classificaram como normais ou anormais. Eles concordaram em 70 das 100 leituras. A concordância esperada apenas pelo acaso, calculada a partir das margens da tabela, foi de 50%. O valor do coeficiente kappa e a sua interpretação são:
O kappa desconta a concordância devida ao acaso: κ = (Po − Pe)/(1 − Pe) = (0,70 − 0,50)/(1 − 0,50) = 0,20/0,50 = 0,40. Na escala adaptada de Landis e Koch, valores de 0,21 a 0,40 correspondem a concordância sofrível — bem abaixo do que a concordância bruta de 70% sugeria, porque metade daquela concordância já era esperada sem que ninguém olhasse a radiografia. Responder 0,70 confunde kappa com a própria concordância bruta observada. Responder 0,20 usa apenas a diferença Po − Pe, sem dividir por (1 − Pe), que é o espaço que restava para concordar além do acaso. Responder 0,50 repete a concordância esperada pelo acaso, que é o que o kappa justamente subtrai. E 0,35 não sai de nenhuma etapa da conta — embora caia na mesma faixa qualitativa, o valor exigido é o resultado da fórmula.
Um marcador quantitativo vinha sendo usado como triagem, com o limiar de positividade calibrado para não perder casos. O serviço decide passar a usá-lo como exame de confirmação: a partir de agora, o resultado positivo indicará uma ressecção cirúrgica de grande porte, sem outro exame intermediário. Qual é a conduta correta quanto ao ponto de corte?
Mover o ponto de corte é jogo de soma quase zero: subir o limiar reduz o número de positivos, eleva a especificidade e derruba a sensibilidade; baixá-lo faz o contrário. Não existe corte que melhore as duas ao mesmo tempo. Quando o resultado positivo dispara um procedimento de risco, o erro caro é o falso-positivo, e a escolha é o corte mais específico — é a mesma lógica que faz os programas usarem triagem sensível na frente e confirmação específica atrás. Baixar o limiar aumentaria a sensibilidade e ainda afirma que o corte não altera a especificidade, o que contraria a definição das duas medidas. Repetir o mesmo exame em série eleva a especificidade e reduz a sensibilidade, nunca as duas juntas. Sustentar que subir o limiar aumenta sensibilidade e especificidade simultaneamente descreve um exame que não existe. E o corte que maximiza o índice de Youden atribui peso igual aos dois erros, o que só serve quando errar para um lado custa o mesmo que errar para o outro — exatamente o que deixou de valer quando o resultado passou a indicar cirurgia.
Num pronto atendimento, adultos com determinado quadro têm probabilidade pré-teste de 20% para a condição investigada. O serviço dispõe de um exame de sangue com sensibilidade de 60% e especificidade de 55%, e a equipe discute se vale a pena solicitá-lo antes de decidir a conduta.
A razão de verossimilhança positiva é a sensibilidade dividida por 1 − especificidade: 0,60/0,45 = 1,33. Convertendo a probabilidade pré-teste em chance, 0,20/0,80 = 0,25; multiplicando pela razão, 0,25 × 1,33 = 0,33; e voltando para probabilidade, 0,33/1,33 = 0,25, ou 25%. O resultado negativo faria o caminho oposto, com razão de verossimilhança negativa de 0,40/0,55 = 0,73 e probabilidade pós-teste de cerca de 15%. Razões próximas de 1 quase não movem a probabilidade, e um exame que deixa o quadro entre 15% e 25% não altera decisão nenhuma — solicitá-lo consome recurso e tempo sem mudar a conduta. Dividir a sensibilidade pela especificidade dá 1,09 e não é a fórmula da razão de verossimilhança. Responder cerca de 60% apenas repete a sensibilidade medida. Tratar qualquer razão acima de 1 como confirmação ignora as faixas de leitura, em que só valores acima de 10 produzem mudanças grandes e frequentemente conclusivas. E o valor preditivo positivo publicado por outro serviço não se transporta, porque ele pertence ao exame naquela população, e não ao exame.
Um fabricante oferece a uma secretaria municipal um teste para uma condição cuja prevalência na população-alvo é de 0,5%. O material de divulgação destaca a acurácia global de 96,8%, medida em um estudo com 20.000 pessoas, no qual a sensibilidade foi de 60% e a especificidade, de 97%. A equipe técnica precisa decidir o que esse número autoriza concluir.
Com prevalência de 0,5% em 20.000 pessoas há 100 doentes e 19.900 sadios. A sensibilidade de 60% produz 60 verdadeiros-positivos e 40 falsos-negativos; a especificidade de 97% produz 19.303 verdadeiros-negativos e 597 falsos-positivos. A acurácia é 19.363/20.000 = 96,8%. Um procedimento que respondesse negativo para todo mundo acertaria os 19.900 sadios e teria 99,5% de acurácia com sensibilidade zero — demonstração de que a acurácia mistura as duas colunas com peso proporcional ao tamanho delas, e em condição rara a coluna dos sadios domina o resultado. O índice de Youden, que pesa igualmente os dois erros, vale 0,60 + 0,97 − 1 = 0,57. Ler os 96,8% como proporção de doentes identificados troca acurácia por sensibilidade, que aqui é 60%. Afirmar que a acurácia supera a do procedimento que nega todo mundo contraria a conta. Igualar o índice de Youden à especificidade ignora que a fórmula soma as duas medidas e subtrai 1. E dizer que a acurácia independe da prevalência inverte a propriedade: quem atravessa a mudança de prevalência é a dupla sensibilidade e especificidade, e com ela as razões de verossimilhança.
Um teste de rastreamento é aplicado a 1.000 pessoas, das quais 100 têm a doença. O teste identificou corretamente 90 doentes e apontou como positivos 180 indivíduos no total. Qual a sensibilidade e o valor preditivo positivo do teste?
Sensibilidade é a proporção de doentes detectados pelo teste: 90 verdadeiros positivos entre 100 doentes, ou 90%. O valor preditivo positivo é a proporção de doentes entre os que testaram positivo: 90 entre 180, ou 50%. Trocar os dois valores é o erro clássico, e ele acontece porque ambos partem do mesmo numerador — a diferença está no denominador, que na sensibilidade é o total de doentes e no valor preditivo positivo é o total de positivos. Vale lembrar que o valor preditivo depende da prevalência, enquanto sensibilidade e especificidade não.
Um mesmo teste diagnóstico é aplicado em um ambulatório de referência, com alta prevalência da doença, e depois em rastreamento populacional, com baixa prevalência. O que ocorre com os valores preditivos?
Sensibilidade e especificidade são propriedades intrínsecas do teste e não mudam com a prevalência, mas os valores preditivos, sim: quanto menor a prevalência, maior a proporção de falsos-positivos entre os positivos, derrubando o valor preditivo positivo e elevando o negativo. Achar que os preditivos são fixos engana quem trata todos os indicadores como características do exame, e é justamente esse erro que leva a interpretar mal um resultado positivo em rastreamento populacional, onde a maioria dos positivos pode não ter a doença.
Ao comparar dois testes diagnósticos pela curva ROC, qual interpretação está correta?
A curva ROC relaciona sensibilidade e a taxa de falsos-positivos ao longo de todos os pontos de corte possíveis, e a área sob a curva resume a capacidade discriminatória: quanto mais próxima de 1, melhor, sendo 0,5 equivalente ao acaso. Confundir 0,5 com desempenho perfeito é o erro mais direto. A curva não depende da prevalência, ao contrário dos valores preditivos, e não dispensa a escolha de um ponto de corte para a prática — essa escolha depende do custo relativo de errar para mais ou para menos naquele contexto clínico.
Um novo teste para determinada doença foi avaliado em população com prevalência de 2%. O teste tem sensibilidade de 95% e especificidade de 90%. O que se espera do valor preditivo positivo nessa população?
Sensibilidade e especificidade são propriedades intrínsecas do teste, mas os valores preditivos dependem da prevalência: com apenas 2% de doentes, o grande número de não doentes gera muitos falso-positivos, e o valor preditivo positivo despenca. Achar que a alta sensibilidade garante bom valor preditivo positivo é o equívoco mais frequente na interpretação de rastreamentos populacionais — a alta sensibilidade, na verdade, favorece o valor preditivo negativo e a função de excluir doença.
Um teste diagnóstico tem seu ponto de corte deslocado para aumentar a sensibilidade. Qual consequência é esperada?
Sensibilidade e especificidade se movem em direções opostas quando se desloca o ponto de corte de um teste com resultado contínuo: ao capturar mais doentes, o teste passa a marcar também mais pessoas saudáveis, e a especificidade cai. Imaginar ganho simultâneo nas duas é o erro conceitual mais comum, e só ocorreria com a substituição do teste por outro melhor, deslocando toda a curva característica de operação. O deslocamento tende, ainda, a melhorar o valor preditivo negativo.
Uma pesquisadora avalia novo teste rápido para hepatite C em população de alta prevalência. O teste foi aplicado em 1.000 pessoas, das quais 200 tinham a doença confirmada pelo padrão-ouro. O teste foi positivo em 180 doentes e em 80 não doentes. Qual é o valor preditivo positivo do teste nessa população?
O valor preditivo positivo é a proporção de doentes entre todos os testes positivos: 180 verdadeiros positivos divididos por 260 positivos totais, resultando em aproximadamente 69,2%. O valor de 90% corresponde à sensibilidade (180 de 200 doentes detectados). O valor de 95% corresponde à especificidade (720 de 800 não doentes com teste negativo). O valor de 20% é a prevalência da doença na amostra, que influencia o valor preditivo, mas não é ele.
Um estudo de acurácia comparou dois testes para a mesma doença. O teste X tem sensibilidade de 98% e especificidade de 70%; o teste Y tem sensibilidade de 75% e especificidade de 99%. O objetivo é usar um deles como triagem inicial em população geral, com confirmação posterior por outro método. Qual escolha é a mais apropriada e por quê?
Na triagem busca-se não deixar escapar doentes, e por isso prioriza-se sensibilidade elevada, aceitando falso-positivos que serão resolvidos pelo teste confirmatório. Escolher o exame mais específico como triagem aumenta falso-negativos, justamente o erro mais grave nessa etapa. Reduzir falso-positivos é objetivo da etapa confirmatória, não da triagem. Afirmar intercambialidade ignora que as duas propriedades têm consequências distintas conforme a finalidade do teste.
Um município implanta um programa de rastreamento com novo teste para determinada doença cuja prevalência local é de 1%. O teste tem sensibilidade de 95% e especificidade de 90%. O gestor questiona a equipe sobre a interpretação prática de um resultado positivo em uma pessoa assintomática da população geral, uma vez que a expectativa da gestão é confirmar diagnósticos com alta segurança apenas com esse exame, sem necessidade de teste confirmatório subsequente. A resposta tecnicamente correta é:
Valores preditivos dependem da prevalência: com prevalência de 1% e especificidade de 90%, os falso-positivos superam largamente os verdadeiros positivos, de modo que a maioria dos resultados positivos não corresponde a doentes, o que torna indispensável a confirmação. Afirmar que o valor preditivo positivo depende só da sensibilidade é incorreto, pois ele decorre da combinação de sensibilidade, especificidade e prevalência. Especificidade de 90% significa 10% de falso-positivos entre os sadios, que são a imensa maioria nessa população. Sensibilidade e especificidade são relativamente estáveis, mas os valores preditivos variam com a prevalência.
Uma equipe implanta testagem rápida para uma infecção em população de baixa prevalência, utilizando um teste com sensibilidade e especificidade elevadas. Nas primeiras semanas, vários resultados reagentes não se confirmam nos testes complementares, gerando ansiedade nos usuários e dúvidas na equipe sobre a qualidade do teste. Um profissional pergunta por que isso ocorre mesmo com um teste de bom desempenho, e como isso afeta a interpretação dos resultados na prática. Qual é a explicação correta?
Sensibilidade e especificidade são características do teste e não variam com a prevalência, mas os valores preditivos dependem dela, de modo que em populações de baixa prevalência o valor preditivo positivo cai e a proporção de falso-positivos entre os reagentes aumenta, justificando os fluxos de confirmação. Afirmar que a sensibilidade cai com a prevalência confunde os conceitos. A especificidade também não depende da prevalência. O valor preditivo negativo, ao contrário, tende a ser mais alto quando a prevalência é baixa.
Uma equipe de vigilância avalia um novo teste diagnóstico para determinada doença e verifica que, entre as pessoas doentes, o resultado positivo ocorre com frequência dez vezes maior do que entre as pessoas sem a doença. A equipe utiliza esse valor para estimar como o resultado do teste modifica a probabilidade de doença de um paciente, partindo da probabilidade estimada antes da realização do exame e calculando a nova probabilidade após o resultado obtido. A medida utilizada nesse raciocínio é:
A razão de verossimilhança positiva expressa quantas vezes um resultado positivo é mais provável em doentes do que em não doentes, permitindo converter a probabilidade pré-teste em probabilidade pós-teste e sendo particularmente útil por não depender diretamente da prevalência. A prevalência informa a probabilidade pré-teste, mas não a modificação produzida pelo resultado. O risco relativo compara incidências entre grupos de exposição. O número necessário para tratar avalia efeito de intervenções terapêuticas, não desempenho diagnóstico.
Uma equipe de vigilância acompanha a implantação de um novo teste diagnóstico em uma rede de serviços e observa que, ao ser aplicado em população com baixa prevalência da doença, grande proporção dos resultados positivos não se confirma na investigação subsequente, apesar de o teste apresentar sensibilidade e especificidade elevadas quando avaliado em estudos realizados em serviços de referência com pacientes já selecionados por suspeita clínica prévia. A explicação correta para o achado é:
O valor preditivo positivo depende diretamente da prevalência: em populações de baixa prevalência, mesmo testes com alta sensibilidade e especificidade produzem grande proporção de resultados falso-positivos entre os positivos, o que explica o achado descrito. Sensibilidade e especificidade são propriedades do teste e não variam com a prevalência, embora possam diferir conforme o espectro da doença. O achado é esperado estatisticamente e não indica necessariamente erro laboratorial.
Em uma unidade básica de saúde, o médico avalia a investigação de uma condição pouco frequente. Está disponível um teste rápido de alta sensibilidade e especificidade moderada e, em seguida, um segundo teste de alta especificidade realizado apenas nos positivos do primeiro. O médico explica ao residente por que a estratégia foi montada nessa sequência, considerando o efeito sobre os resultados falso-positivos e o custo do fluxo. Qual é o efeito de aplicar os dois testes em série, exigindo positividade em ambos?
Exigir positividade em dois testes aplicados em série eleva a especificidade do conjunto e reduz os falso-positivos, ao custo de alguma perda de sensibilidade, e é a lógica de usar teste sensível na triagem e teste específico na confirmação. Testes em paralelo, com positividade em qualquer um deles, é que aumentam a sensibilidade e reduzem falso-negativos. Afirmar que o desempenho não muda ignora a combinação sequencial das probabilidades. Prevalência é característica da população e não se altera pela estratégia de testagem, embora a probabilidade pós-teste mude a cada etapa.
O laboratório central discute com a coordenação da atenção primária a mudança do ponto de corte de um exame quantitativo usado para triagem de uma doença grave e tratável. A proposta é reduzir o valor de corte, de modo que mais pessoas sejam consideradas positivas na triagem inicial e encaminhadas para o exame confirmatório. A coordenação quer entender as consequências dessa mudança sobre o desempenho do teste na triagem. Qual é o efeito esperado da redução do ponto de corte?
Reduzir o ponto de corte de um exame quantitativo faz com que mais indivíduos sejam classificados como positivos, o que captura mais doentes e aumenta a sensibilidade, mas também rotula mais sadios como positivos, reduzindo a especificidade e o valor preditivo positivo. Não é possível aumentar as duas propriedades apenas deslocando o corte, pois elas variam em sentidos opostos ao longo da curva. Redução da sensibilidade ocorreria com elevação do corte. Aumento da especificidade com menos falso-positivos também corresponde a elevar, e não a reduzir, o valor de corte.
Mulher, 46 anos, é submetida a rastreamento com um teste cujo resultado positivo indica encaminhamento para exame confirmatório. Na população rastreada, a prevalência da doença é de 2%. O teste tem sensibilidade de 90% e especificidade de 90%. A gestora do município questiona o médico sobre a chance de a paciente com teste positivo realmente ter a doença. Qual afirmação está correta?
Com prevalência de 2% em 10.000 pessoas, haveria 200 doentes, dos quais 180 seriam detectados, e 9.800 sadios, dos quais 980 teriam falso-positivo; o valor preditivo positivo é 180 sobre 1.160, ou aproximadamente 15,5%, ilustrando como a baixa prevalência derruba a probabilidade pós-teste. Igualar valor preditivo positivo à sensibilidade é erro conceitual, pois a sensibilidade parte dos doentes e o valor preditivo parte dos que testaram positivo. O valor preditivo negativo, ao contrário do positivo, sobe quando a prevalência cai, chegando a 99,8% neste exemplo. Sensibilidade e especificidade são propriedades intrínsecas do teste e não variam com a prevalência. A razão de verossimilhança positiva é a sensibilidade dividida por 1 menos a especificidade, ou seja, 9 neste caso, e independe da prevalência.
Um estudo avaliou novo teste diagnóstico para determinada infecção em 500 pessoas, comparando-o ao padrão-ouro. Entre os 100 doentes, o teste foi positivo em 85. Entre os 400 sem a doença, o teste foi negativo em 360. O pesquisador afirma que o teste é excelente para rastreamento populacional e que sua principal virtude é minimizar diagnósticos falsamente positivos em populações de baixa prevalência. Com base nos dados, é correto afirmar que:
A sensibilidade é 85 sobre 100, ou 85%, e a especificidade é 360 sobre 400, ou 90%, restando 40 falsos-positivos, o que contraria a alegação do pesquisador de que o teste minimiza resultados falsamente positivos. Inverter os valores para 90% de sensibilidade e 85% de especificidade não corresponde à tabela, e maior sensibilidade favorece triagem, não confirmação. O valor preditivo negativo é perfeitamente calculável: 360 verdadeiros-negativos sobre 375 resultados negativos, chegando a 96%. Atribuir especificidade de 96% confunde esse valor preditivo negativo com a especificidade. A acurácia é a soma de acertos, 85 mais 360, sobre 500, o que dá 89%, e não é a média aritmética de sensibilidade e especificidade.
Um novo teste para tuberculose foi avaliado em 1.000 pessoas de uma população em que 100 têm a doença confirmada pelo padrão-ouro. O teste foi positivo em 90 dos 100 doentes e em 90 dos 900 não doentes. Os pesquisadores desejam interpretar o desempenho desse teste antes de recomendá-lo para uso em campo, em uma população com prevalência semelhante à do estudo. Qual o valor preditivo positivo do teste?
O valor preditivo positivo é a proporção de doentes entre os que testaram positivo: são 90 verdadeiros positivos e 90 falsos positivos, totalizando 180 positivos, de modo que 90 dividido por 180 resulta em 50%. O valor de 90% corresponde à sensibilidade, que mede a capacidade de detectar os doentes, e também à especificidade neste exemplo, mas não à probabilidade pós-teste. O valor de 10% corresponde à prevalência da doença na população estudada, que é a probabilidade pré-teste. O valor de 80% não corresponde a nenhuma das medidas calculáveis com esses dados. O valor de 95% superestima o desempenho e não decorre da tabela apresentada.
Um novo teste diagnóstico apresenta sensibilidade de 95% e especificidade de 90%. Ele é aplicado em duas situações distintas: primeiro em uma população de rastreamento com prevalência da doença de 1%, e depois em uma população sintomática de ambulatório especializado, na qual a prevalência é de 40%. Os parâmetros intrínsecos do teste são os mesmos nas duas situações. O que acontece com os valores preditivos entre as duas situações?
Os valores preditivos dependem da prevalência, de modo que o valor preditivo positivo é muito maior na população com prevalência de 40% do que na população de rastreamento com 1%, na qual predominam os falso-positivos. Afirmar que o valor preditivo positivo é idêntico confunde-o com sensibilidade e especificidade, que são propriedades intrínsecas do teste. A sensibilidade não varia com a prevalência, pois é calculada apenas entre os doentes. O valor preditivo negativo comporta-se de forma inversa e é maior quando a prevalência é baixa. A especificidade também não se altera com a prevalência, sendo calculada apenas entre os não doentes.
Uma equipe implanta protocolo de rastreamento de depressão na UBS usando duas perguntas iniciais sobre humor deprimido e anedonia nas últimas duas semanas. O instrumento tem sensibilidade de 96% e especificidade de 57%. A coordenação questiona se esse desempenho é adequado para a primeira etapa do rastreamento e o que deve ser feito com os resultados positivos. Qual a interpretação correta?
Instrumentos de triagem privilegiam a sensibilidade, para não deixar escapar quem tem a condição, aceitando falsos-positivos que serão depurados em uma etapa confirmatória com entrevista clínica ou instrumento mais específico. Preferir alta especificidade com baixa sensibilidade em triagem é inverter a lógica, pois deixaria muitos casos sem identificação. Exigir especificidade acima de 90% como regra universal para rastreamento é equivocado, já que o desempenho desejado depende da finalidade da etapa. Considerar o resultado positivo como diagnóstico e iniciar antidepressivo leva a tratamento desnecessário em grande proporção de pessoas, dada a especificidade de 57%. Reavaliar todos os negativos com entrevista estruturada anularia o ganho de eficiência do rastreamento, pois a alta sensibilidade torna o resultado negativo bastante confiável.
Uma pesquisadora avalia a acurácia de um novo teste em relação ao padrão-ouro e constrói uma curva de característica de operação do receptor. A área sob a curva resulta em 0,92, e ela precisa escolher um ponto de corte para uso em um programa de rastreamento populacional, no qual a prioridade é não deixar de identificar pessoas doentes, aceitando maior número de resultados falso-positivos na triagem inicial. Qual escolha é coerente com esse objetivo?
Em rastreamento populacional, cujo objetivo é não perder doentes, escolhe-se ponto de corte que privilegie a sensibilidade, aceitando queda da especificidade e maior número de falso-positivos, que serão depois esclarecidos por teste confirmatório. Maximizar a especificidade é estratégia de teste confirmatório, e não de triagem. Igualar sensibilidade a valor preditivo positivo não é critério de escolha de corte, pois o valor preditivo depende da prevalência. Área sob a curva de 0,92 indica boa acurácia, e não motivo para abandonar o teste. O ponto de corte determina diretamente sensibilidade e especificidade, jamais podendo ser escolhido aleatoriamente.
Um serviço implanta teste de rastreamento com sensibilidade de 90% e especificidade de 95% para determinada lesão cervical. O teste é aplicado primeiro em população de alto risco, com prevalência de 12%, e depois em população geral assintomática, com prevalência de 0,5%. A equipe observa que a proporção de resultados positivos que se confirmam na investigação subsequente muda de forma expressiva entre os dois cenários. Sobre esses índices de desempenho, assinale a alternativa INCORRETA.
A afirmação incorreta é a independência do valor preditivo positivo em relação à prevalência: esse índice depende diretamente da probabilidade pré-teste, e é justamente por isso que o desempenho observado mudou entre as duas populações. A relativa estabilidade da sensibilidade e da especificidade decorre de serem propriedades intrínsecas do teste, medidas em relação ao padrão de referência. A queda do valor preditivo positivo em baixa prevalência é o fenômeno observado no cenário de população geral. O aumento do valor preditivo negativo em baixa prevalência é a contrapartida esperada. O crescimento de investigações desnecessárias é a consequência prática dessa queda, com custo e dano potencial às mulheres rastreadas.
Um teste diagnóstico para determinada doença apresenta sensibilidade de 90% e especificidade de 95%. Um clínico deseja quantificar quanto um resultado positivo modifica a probabilidade pré-teste de um paciente específico, sem depender da prevalência da população de origem, e por isso decide utilizar a razão de verossimilhança positiva do teste. Qual o valor dessa razão e sua interpretação?
O valor é 18, indicando aumento importante da probabilidade após resultado positivo: a razão de verossimilhança positiva é a sensibilidade dividida pelo complemento da especificidade, ou seja, 0,90 dividido por 0,05. O valor 0,9 corresponderia a um teste praticamente inútil e não resulta desse cálculo. O valor 0,11 é a razão de verossimilhança negativa, obtida pelo complemento da sensibilidade dividido pela especificidade. O valor 1 significaria teste sem poder discriminatório. Igualar a razão ao percentual de especificidade confunde duas medidas distintas.
Em um serviço de referência, decidiu-se aplicar dois testes diagnósticos para a mesma doença, considerando positivo apenas quem tiver resultado positivo em ambos. A doença tem tratamento com efeitos adversos importantes, e o objetivo declarado é evitar tratar quem não tem a doença, mesmo que alguns doentes deixem de ser identificados nessa etapa. Qual o efeito dessa estratégia sobre o desempenho diagnóstico?
A estratégia aumenta a especificidade e reduz a sensibilidade: exigir positividade nos dois testes, isto é, testar em série, torna mais difícil ser classificado como doente, o que diminui falsos-positivos e é coerente com o objetivo de evitar tratamento desnecessário. Aumentar sensibilidade com queda de especificidade é o efeito de testar em paralelo, considerando positivo quem for positivo em qualquer um. Afirmar que nada se altera ignora o efeito matemático da combinação. Não é possível aumentar as duas medidas simultaneamente com essa manobra. Reduzir ambas também não corresponde ao efeito descrito.
Serviço de vigilância avalia a introdução de um teste rápido para determinada infecção em população com prevalência estimada de 2%. O teste apresenta sensibilidade de 95% e especificidade de 90%, conforme estudos prévios. A equipe discute como interpretar resultados positivos e negativos nesse cenário e como orientar a confirmação laboratorial dos casos identificados na triagem. Sobre esse tema, assinale a alternativa correta.
Em populações de baixa prevalência, o valor preditivo positivo tende a ser baixo, pois a proporção de falso-positivos cresce em relação aos verdadeiro-positivos, o que justifica a confirmação laboratorial dos casos triados. Afirmar que o valor preditivo positivo independe da prevalência é incorreto, já que essa dependência é justamente sua característica central. A sensibilidade é propriedade do teste e não varia com a prevalência. Nenhum teste com sensibilidade de 95% exclui a doença com certeza. A especificidade mede a proporção de não doentes corretamente identificados, e não de doentes.
Um laboratório reduz o ponto de corte de um marcador, passando a considerar positivos valores antes classificados como negativos. Mantidos população e padrão-ouro, qual combinação é esperada?
Um limiar mais baixo identifica mais doentes, mas também classifica mais não doentes como positivos. Referência: CDC. Principles of Epidemiology in Public Health Practice, 3ª edição. Dados e cálculos fictícios elaborados para esta questão. https://stacks.cdc.gov/view/cdc/6914
Uma mulher tem probabilidade pré-teste de 50% para determinada doença. Um resultado negativo apresenta razão de verossimilhança negativa de 0,10. Qual é a probabilidade pós-teste aproximada?
Odds pré-teste = 1; odds pós-teste = 0,10. Probabilidade = 0,10/1,10 ≈ 9,1%. Referência: CDC. Principles of Epidemiology in Public Health Practice, 3ª edição. Dados e cálculos fictícios elaborados para esta questão. https://stacks.cdc.gov/view/cdc/6914
Em um paciente, a probabilidade pré-teste de uma doença é 20%. O teste positivo tem razão de verossimilhança positiva de 8. Qual é a probabilidade pós-teste aproximada?
Odds pré-teste = 0,20/0,80 = 0,25; multiplicadas por 8 dão 2. Probabilidade = 2/3. Referência: CDC. Principles of Epidemiology in Public Health Practice, 3ª edição. Dados e cálculos fictícios elaborados para esta questão. https://stacks.cdc.gov/view/cdc/6914
Um teste com sensibilidade de 90% e especificidade de 90% é aplicado a 1.000 pessoas de uma população com prevalência de 10%. Admitindo desempenho constante e padrão-ouro em todos, qual é o valor preditivo positivo esperado?
Há 90 verdadeiros positivos e 90 falsos positivos; VPP = 90/(90 + 90) = 50%. Referência: CDC. Principles of Epidemiology in Public Health Practice, 3ª edição. Dados e cálculos fictícios elaborados para esta questão. https://stacks.cdc.gov/view/cdc/6914
Um exame tem sensibilidade de 80% e especificidade de 90%. A expressão 0,80/(1−0,90) resulta em 8, sem usar diretamente a prevalência. Qual medida está sendo descrita ou calculada?
A fórmula apresentada é a RV+, que será combinada às odds pré-teste. RV+ é sensibilidade dividida por um menos a especificidade; multiplica as odds pré-teste para obter odds pós-teste após resultado positivo. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Mantidas as propriedades do teste, uma população de menor prevalência apresenta maior proporção de pessoas sem doença entre os resultados negativos. Qual medida está sendo descrita ou calculada?
A medida condicionada ao negativo que aumenta nesse cenário é o VPN. VPN é a proporção de pessoas sem a condição entre as que testaram negativo; varia com a prevalência e o contexto clínico. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Mantidas sensibilidade e especificidade, o mesmo teste positivo é mais convincente numa população de alta prevalência do que em rastreamento de baixo risco. Qual medida está sendo descrita ou calculada?
O valor preditivo positivo aumenta com a probabilidade pré-teste, mantidas as demais condições. VPP é a proporção de pessoas com a condição entre as que testaram positivo; depende da probabilidade pré-teste e das propriedades do teste. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Ao elevar o ponto de corte de um marcador positivo por valores altos, maior fração dos não doentes recebe resultado negativo, às custas de perder alguns doentes. Qual medida está sendo descrita ou calculada?
A propriedade aumentada entre os não doentes é a especificidade. Especificidade é a proporção de resultados negativos entre as pessoas sem a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Ao reduzir o ponto de corte de um marcador positivo por valores altos, o teste passa a identificar maior fração dos doentes, embora produza mais falsos positivos. Qual medida está sendo descrita ou calculada?
A propriedade aumentada entre os doentes é a sensibilidade. Sensibilidade é a proporção de resultados positivos entre as pessoas que têm a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
O resultado positivo é dez vezes mais provável em quem tem a doença do que em quem não tem. A equipe usa esse quociente para atualizar a suspeita. Qual medida está sendo descrita ou calculada?
A comparação de probabilidades de positividade entre doentes e não doentes é RV+. RV+ é sensibilidade dividida por um menos a especificidade; multiplica as odds pré-teste para obter odds pós-teste após resultado positivo. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Entre 900 pessoas com resultado negativo, nove são falsos negativos e 891 são verdadeiros negativos. Calcula-se 891/900. Qual medida está sendo descrita ou calculada?
O denominador de resultados negativos identifica o VPN, de 99%. VPN é a proporção de pessoas sem a condição entre as que testaram negativo; varia com a prevalência e o contexto clínico. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Após rastrear uma população, 40 dos 100 resultados positivos são confirmados. A equipe explica por que um positivo não equivale automaticamente a diagnóstico. Qual medida está sendo descrita ou calculada?
O VPP é 40%, calculado entre os resultados positivos, não entre todos os doentes. VPP é a proporção de pessoas com a condição entre as que testaram positivo; depende da probabilidade pré-teste e das propriedades do teste. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Um novo teste é comparado ao padrão de referência em 400 não doentes e fornece 380 negativos. O índice expressa capacidade de reconhecer ausência da doença. Qual medida está sendo descrita ou calculada?
A proporção 380/400 corresponde à especificidade de 95%. Especificidade é a proporção de resultados negativos entre as pessoas sem a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Em validação, o padrão de referência identifica 250 doentes; o teste em avaliação é positivo em 225 deles. O índice tem como denominador 250. Qual medida está sendo descrita ou calculada?
A proporção 225/250 mede sensibilidade de 90%. Sensibilidade é a proporção de resultados positivos entre as pessoas que têm a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
A probabilidade pré-teste é convertida em odds, multiplicada por 8 após teste positivo e reconvertida em probabilidade. O fator 8 é a medida procurada. Qual medida está sendo descrita ou calculada?
O multiplicador das odds após um positivo é a razão de verossimilhança positiva. RV+ é sensibilidade dividida por um menos a especificidade; multiplica as odds pré-teste para obter odds pós-teste após resultado positivo. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Após resultado negativo, um paciente pergunta qual a probabilidade de não ter a doença. A resposta deve considerar o contexto e não apenas uma propriedade fixa do ensaio. Qual medida está sendo descrita ou calculada?
Probabilidade de ausência da doença condicionada ao teste negativo é VPN. VPN é a proporção de pessoas sem a condição entre as que testaram negativo; varia com a prevalência e o contexto clínico. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Uma mulher assintomática pergunta, após teste positivo, qual a chance de realmente estar doente. O médico considera a baixa prevalência da condição em seu grupo. Qual medida está sendo descrita ou calculada?
A pergunta condiciona a doença ao resultado positivo, portanto se refere ao VPP. VPP é a proporção de pessoas com a condição entre as que testaram positivo; depende da probabilidade pré-teste e das propriedades do teste. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Um teste é positivo em 4% das pessoas sem a doença. A equipe usa 1 menos 0,04 e informa 96% de classificação correta entre não doentes. Qual medida está sendo descrita ou calculada?
O complemento da taxa de falsos positivos é a especificidade. Especificidade é a proporção de resultados negativos entre as pessoas sem a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Um exame deixou de detectar 15 dos 100 pacientes sabidamente doentes. A equipe informa que ele identificou corretamente 85% dos doentes. Qual medida está sendo descrita ou calculada?
Complementar a proporção de falsos negativos entre doentes fornece sensibilidade. Sensibilidade é a proporção de resultados positivos entre as pessoas que têm a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Um teste tem sensibilidade de 0,90 e especificidade de 0,95. O pesquisador divide 0,90 por 0,05 e obtém 18. Qual medida está sendo descrita ou calculada?
A razão entre sensibilidade e taxa de falsos positivos define RV+. RV+ é sensibilidade dividida por um menos a especificidade; multiplica as odds pré-teste para obter odds pós-teste após resultado positivo. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Entre 500 testes negativos, 490 correspondem a pessoas sem doença. Calcula-se 490/500 para orientar a interpretação do resultado negativo. Qual medida está sendo descrita ou calculada?
A proporção de verdadeiros negativos entre todos os negativos é o VPN, de 98%. VPN é a proporção de pessoas sem a condição entre as que testaram negativo; varia com a prevalência e o contexto clínico. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Em serviço de diagnóstico, 120 pessoas têm teste positivo; 90 delas realmente possuem a doença. A pergunta é sobre a probabilidade de doença após esse resultado positivo. Qual medida está sendo descrita ou calculada?
A proporção 90/120, igual a 75%, calcula o valor preditivo positivo. VPP é a proporção de pessoas com a condição entre as que testaram positivo; depende da probabilidade pré-teste e das propriedades do teste. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Entre 800 participantes sem a doença pelo padrão de referência, 760 tiveram resultado negativo. A equipe calcula 760/800. Qual medida está sendo descrita ou calculada?
A fração de não doentes corretamente negativos corresponde a especificidade de 95%. Especificidade é a proporção de resultados negativos entre as pessoas sem a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Entre 200 pacientes cuja doença foi confirmada pelo padrão de referência, 180 tiveram teste positivo. O pesquisador calcula 180/200. Qual medida está sendo descrita ou calculada?
O denominador contém todos os doentes; a proporção encontrada de 90% é sensibilidade. Sensibilidade é a proporção de resultados positivos entre as pessoas que têm a condição segundo o padrão de referência. Referência: https://www.ncbi.nlm.nih.gov/books/NBK557491/
Um teste com as mesmas sensibilidade e especificidade será aplicado em uma população na qual a doença se tornou menos frequente. Qual comportamento do valor preditivo negativo é esperado?
Com menor probabilidade pré-teste, um resultado negativo tende a ser mais tranquilizador, mantidas as características do teste. Referência: NCI/NIH. Cancer Screening Overview (PDQ), Health Professional Version. https://www.cancer.gov/about-cancer/screening/hp-screening-overview-pdq
Para avaliar um novo teste de triagem, os pesquisadores encaminham todos os resultados positivos ao exame de referência, mas consideram os resultados negativos como ausência de doença sem verificação adicional. Ao calcular sensibilidade e especificidade, que limitação central deve ser reconhecida?
Sem verificar adequadamente os negativos, casos doentes nesse grupo podem ficar desconhecidos; trata-se de verificação parcial, que compromete a estimativa de acurácia. Referência: FDA. Statistical Guidance on Reporting Results from Studies Evaluating Diagnostic Tests. https://www.fda.gov/regulatory-information/search-fda-guidance-documents/statistical-guidance-reporting-results-studies-evaluating-diagnostic-tests
Um rastreamento identificou 150 resultados positivos. Após avaliação de referência de todos os participantes, 45 desses positivos tinham a doença. Qual medida é estimada por 45/150?
Entre os testes positivos, 30% correspondiam a pessoas com doença. Referência: NCI/NIH. Cancer Screening Overview (PDQ), Health Professional Version. https://www.cancer.gov/about-cancer/screening/hp-screening-overview-pdq
Um teste tem sensibilidade e especificidade estáveis em dois grupos comparáveis, mas a doença é muito menos prevalente em um deles. Qual diferença se espera no grupo de menor prevalência?
Com menos doentes, os falsos positivos tendem a representar parcela maior dos resultados positivos, mantidas sensibilidade e especificidade. Referência: NCI/NIH. Cancer Screening Overview (PDQ), Health Professional Version. https://www.cancer.gov/about-cancer/screening/hp-screening-overview-pdq
Um marcador será usado na atenção primária para diferenciar causas de fadiga. Sua validação, porém, comparou apenas pacientes internados com doença-alvo avançada a voluntários totalmente saudáveis. Qual limitação deve ser considerada antes de transportar os resultados para o uso pretendido?
A população de validação não representa a diversidade de apresentações e diagnósticos diferenciais da atenção primária, limitando a aplicação direta da acurácia observada. Referência: Bossuyt et al. STARD 2015: reporting diagnostic accuracy studies. https://www.equator-network.org/wp-content/uploads/2015/03/STARD-2015-paper.pdf
Um teste foi calibrado para alta sensibilidade no rastreamento de uma condição tratável. O gestor propõe comunicar qualquer resultado positivo como diagnóstico definitivo para reduzir consultas. Qual objeção é mais adequada, mesmo que a sensibilidade estimada seja de 99%?
A confirmação depende também de especificidade, probabilidade pré-teste e estratégia diagnóstica; sensibilidade alta reduz perdas de casos, mas não garante VPP alto. Referência: NCI/NIH. Cancer Screening Overview (PDQ), Health Professional Version. https://www.cancer.gov/about-cancer/screening/hp-screening-overview-pdq
Um programa considera positivo o resultado final somente quando um teste inicial positivo é seguido por teste confirmatório também positivo. Em comparação ao teste inicial sozinho, qual consequência é esperada para essa regra em série?
Exigir dois resultados positivos restringe o conjunto classificado como positivo: aumenta a especificidade e pode reduzir a sensibilidade. Referência: NCI/NIH. Cancer Screening Overview (PDQ), Health Professional Version. https://www.cancer.gov/about-cancer/screening/hp-screening-overview-pdq
Um serviço considera o rastreamento positivo quando pelo menos um de dois testes é positivo. Comparada ao uso de apenas um deles, qual é a principal troca dessa regra em paralelo?
A união dos positivos inclui casos detectados por cada teste, mas também reúne resultados falsamente positivos. Referência: NCI/NIH. Cancer Screening Overview (PDQ), Health Professional Version. https://www.cancer.gov/about-cancer/screening/hp-screening-overview-pdq
Entre os pontos A, B e C, qual prioriza maior sensibilidade ao custo de mais falsos positivos?
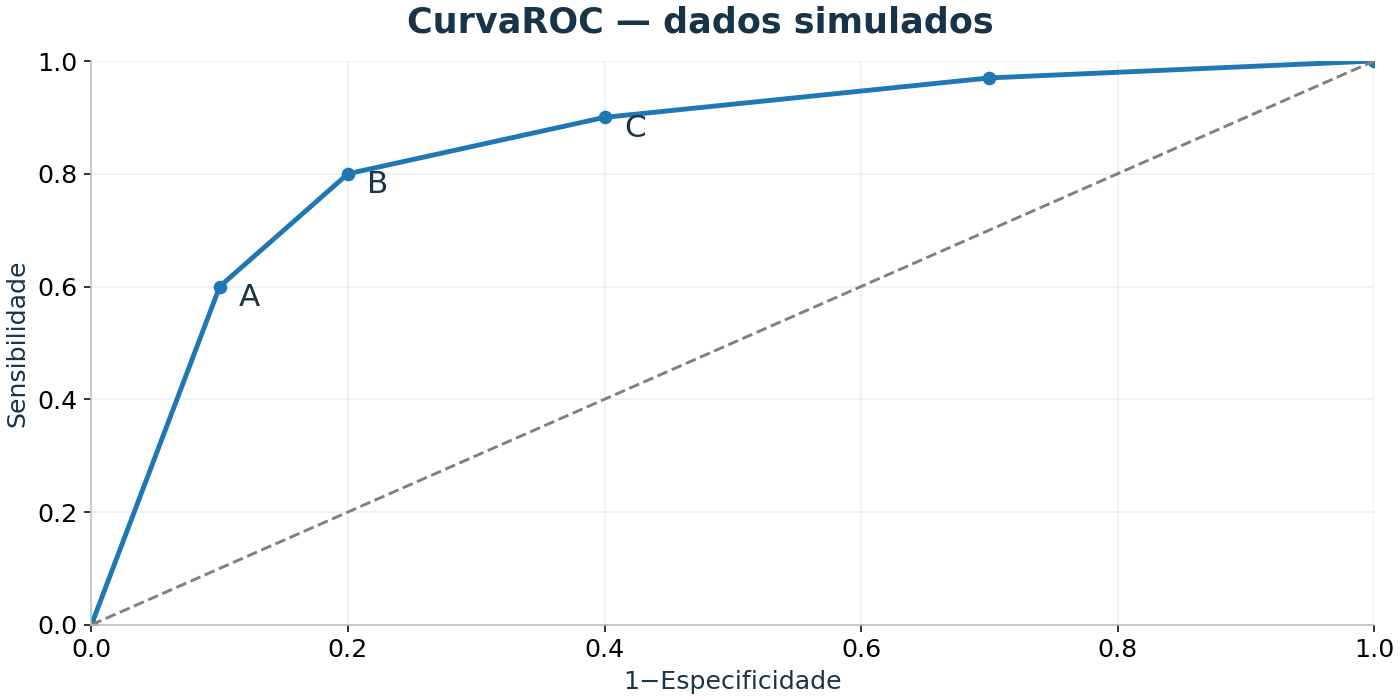
Tem sensibilidade 0,90 e taxa de falsos positivos 0,40.
O que representa a linha diagonal tracejada na ROC?
Sensibilidade igual à taxa de falsos positivos ao longo da diagonal.
Qual é a especificidade do teste na figura?
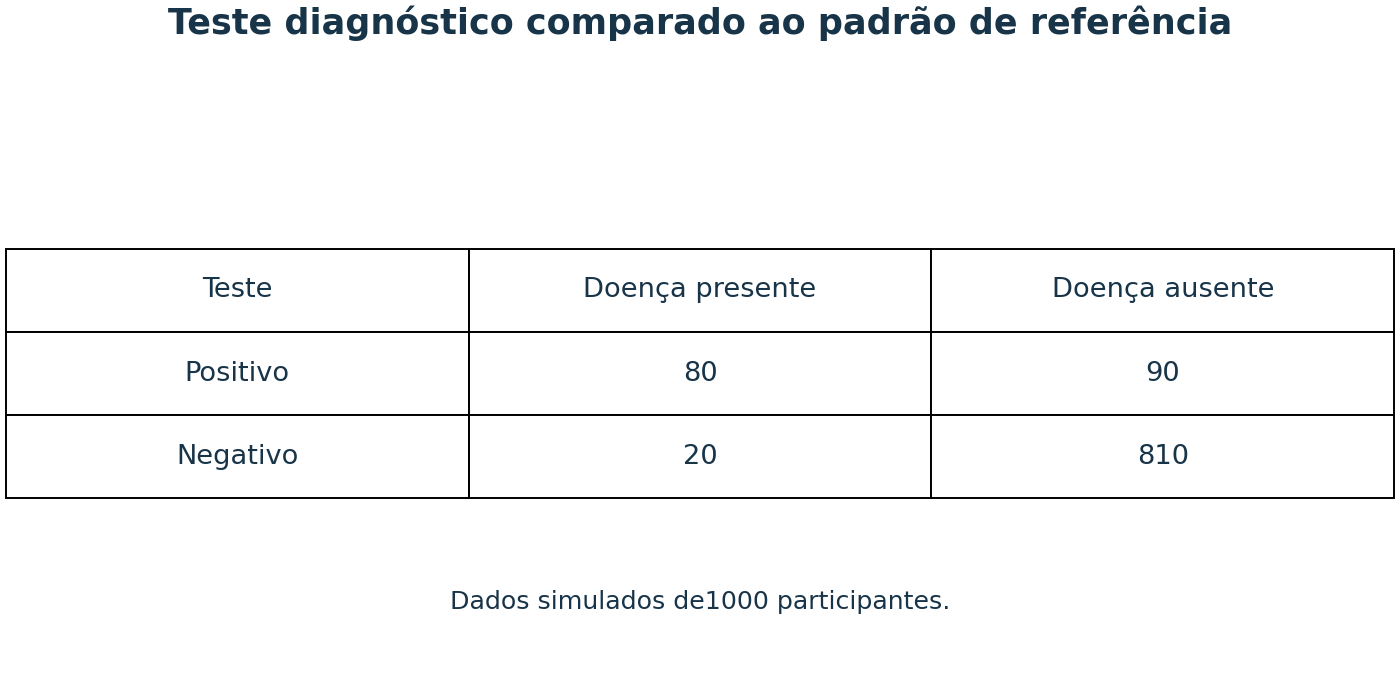
Especificidade=810/(810+90)=90%.
Qual é a razão de verossimilhança positiva usando a tabela?
RV+=sensibilidade/(1−especificidade)=0,80/0,10=8.
Qual é o valor preditivo positivo na população avaliada?
VPP=80/(80+90)≈47,1%.
Qual é a sensibilidade do teste mostrado?
Sensibilidade=80/(80+20)=80%.
Qual índice de Youden (sensibilidade+especificidade−1) corresponde ao ponto B?
0,80+0,80−1=0,60.
Se o teste mantiver o mesmo desempenho em população de menor prevalência, qual mudança é esperada no valor preditivo positivo?
Com menor probabilidade pré-teste, maior fração dos positivos tende a ser falsa.
No ponto B da ROC, qual é a especificidade?
O eixo horizontal é 1−especificidade; em B vale 0,20, então especificidade=0,80.
Qual informação adicional é importante para escolher o ponto de corte entre A, B e C?
A escolha depende da finalidade e dos custos dos erros.
Para reproduzir a tabela em outra amostra, pesquisadores aplicam o padrão de referência somente a quem teve teste positivo. Que problema isso introduz na avaliação da acurácia?
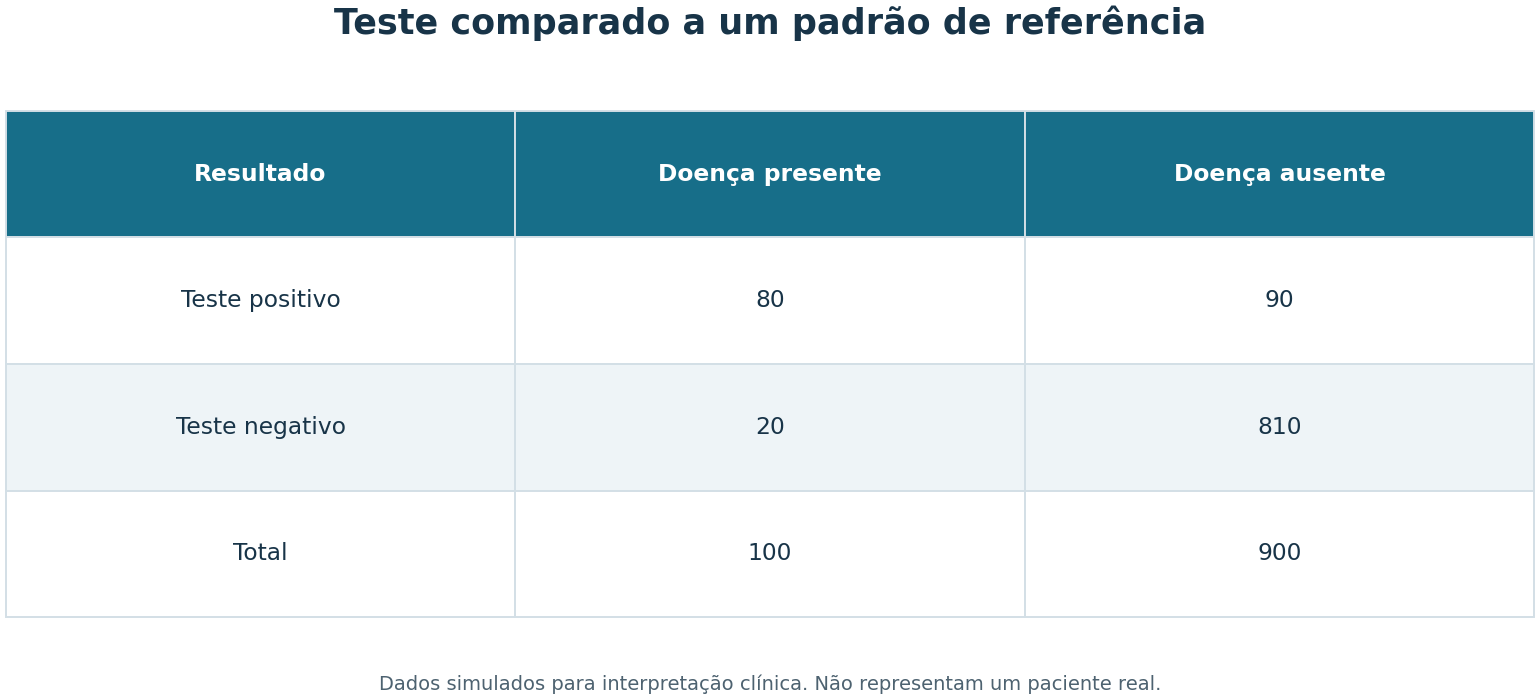
Verificação dependente do resultado do teste impede classificar adequadamente toda a amostra e pode distorcer estimativas de acurácia.
Entre as 900 pessoas sem doença na tabela, 90 receberam teste positivo. Qual é a taxa de falsos positivos?
Taxa de falsos positivos=90/900=10%, complemento da especificidade de 90%.
Dois testes com sensibilidade e especificidade iguais às da tabela são independentes entre si, condicionalmente à presença ou ausência de doença. Se a estratégia só for positiva quando ambos forem positivos, quais serão sua sensibilidade e especificidade?
Com independência condicional e exigência de ambos positivos, sensibilidade=0,8²=0,64. Falso positivo=0,1²=0,01; especificidade=0,99. O pressuposto de independência é essencial.
Considere uma perda hipotética de 100 unidades por falso negativo e de 10 por falso positivo, com perda zero para classificações corretas e custo do teste desconsiderado. Na amostra da tabela, qual estratégia gera a menor perda total?
Teste:20×100+90×10=2.900. Todos positivos:900×10=9.000. Todos negativos:100×100=10.000. A preferência vale para as perdas e amostra explicitadas, não como regra clínica universal.
Qual célula contém os falsos negativos?
Falso negativo é teste negativo em pessoa com doença pelo padrão de referência.
Dois testes têm a mesma área sob a curva ROC, mas apresentam sensibilidades diferentes na faixa de especificidade exigida para evitar um procedimento invasivo desnecessário. Qual informação deve orientar a comparação para esse uso?
Uma medida agregada de discriminação não resolve, isoladamente, a decisão de encaminhar para um procedimento. É preciso avaliar o ponto de operação pretendido. Referências: BMJ. Interpreting diagnostic accuracy studies for patient care, 2012 — https://www.bmj.com/content/345/bmj.e3999
Um novo teste foi aplicado a 200 pacientes, mas 40 amostras geraram resultado inconclusivo. O artigo exclui essas 40 pessoas sem explicação e anuncia excelente desempenho nas restantes. Qual informação é necessária para avaliar sua utilidade na prática?
O leitor precisa saber em quantos pacientes o exame não respondeu à pergunta. Ocultar esse grupo limita a aplicação do resultado ao serviço. Referências: Cohen et al. STARD 2015 guidelines for reporting diagnostic accuracy studies: explanation and elaboration — https://bmjopen.bmj.com/content/6/11/e012799 BMJ. Diagnostic accuracy studies: how to report and analyse inconclusive test results, 2013 — https://www.bmj.com/content/346/bmj.f2778
Em 1.000 pessoas, dez têm a doença pelo padrão de referência. Um algoritmo classifica todas como negativas. O fabricante anuncia acurácia global de 99%. Qual avaliação é correta?
Um resumo global pode ser dominado pela classe mais frequente. A avaliação deve examinar separadamente os resultados entre doentes e não doentes. Referências: BMJ. Interpreting diagnostic accuracy studies for patient care, 2012 — https://www.bmj.com/content/345/bmj.e3999
A probabilidade pré-teste de uma doença é 20%. Um exame aplicável a esse paciente apresenta razão de verossimilhança negativa de 0,10. Após resultado negativo, qual é aproximadamente a probabilidade da doença?
As odds passam de 0,25 para 0,025. A probabilidade final é 0,025/1,025, cerca de 2,4%, e deve ser interpretada no contexto da decisão clínica. Referências: Deeks and Altman. Diagnostic tests 4: likelihood ratios. BMJ 2004 — https://www.bmj.com/content/329/7458/168
Pesquisadores testam dezenas de pontos de corte em uma amostra e publicam somente o que apresentou a maior acurácia nessa mesma amostra. Pretendem usar o desempenho encontrado como estimativa definitiva para novos pacientes. Qual é a principal limitação?
Deve-se distinguir análise previamente especificada de exploração. Avaliar o corte em dados independentes ajuda a estimar o desempenho que poderá ser reproduzido. Referências: Cohen et al. STARD 2015 guidelines for reporting diagnostic accuracy studies: explanation and elaboration — https://bmjopen.bmj.com/content/6/11/e012799
Quer treinar mais nesse tema? Estas questões vêm do nosso banco — lá tem milhares, com simulado, maratona e estatística de acerto por área.
Criar conta grátis e continuar →Plano de revisão
em 7 dias
Refaça de memória a tabela 2×2 com as letras a, b, c e d e escreva as cinco fórmulas ao lado da margem certa — as duas de coluna, as duas de linha e a acurácia no canto. Depois pegue um teste com sensibilidade e especificidade de 90% e calcule o valor preditivo positivo em três prevalências: 50% (use 1.000 pessoas), 10% (use 10.000) e 1% (use 100.000). Confira: 90%, 50% e 8,3%. Se algum não bateu, o erro quase certamente está no denominador, não na conta.
em 30 dias
Monte e resolva um problema completo do zero: um teste com sensibilidade de 80% e especificidade de 95% aplicado a 10.000 pessoas numa população com prevalência de 2%. Calcule a, b, c, d, as cinco medidas, RV+ e RV−, e depois refaça o valor preditivo positivo pela rota das chances para conferir que as duas rotas coincidem. Feche respondendo em uma frase cada: por que a acurácia deste teste engana; o que acontece com o valor preditivo positivo se ele passar a ser usado num pronto-socorro onde a prevalência é de 20%; e qual das medidas você levaria de um cenário para o outro. (Confira: a = 160, b = 490, c = 40, d = 9.310; VPP 24,6%, VPN 99,6%, acurácia 94,7%, RV+ 16, RV− 0,21; e no pronto-socorro com 20% de prevalência o VPP sobe para 80%.)
Agora atenda
Você sabe decidir com a tomografia na mão. A prova prática, e a vida, pedem outra coisa: chegar lá a partir de um paciente que ainda não tem exame nenhum.
Plantão na unidade básica: mulher de 34 anos, sem fatores de risco identificáveis, chega chorando com o resultado de um teste rápido feito numa campanha de rua — reagente. Ela quer saber, agora, se está com a infecção. Assuma o caso: acolha, explique o que um resultado positivo significa numa população de baixa prevalência, conduza o fluxo confirmatório e não prometa o que aquele teste, sozinho, não pode dizer. — você conduz anamnese, exame físico e conduta; o paciente responde em tempo real e o feedback vem no fim.