
Função e Bases Moleculares › A medida: do instrumento ao laudo
Quem julga o juiz
Padrão de referência: quando o exame que valida também erra
Padrão de referência imperfeito: acertar contra quem não vê conta como erro
O caso
A ultrassonografia pulmonar é avaliada contra a radiografia de tórax e sai "falso-positiva" justamente nos casos em que acertou. Isso não é hipótese: está publicado com número. Num estudo em terapia intensiva pediátrica, com 220 ultrassonografias em 117 pacientes, ambos os exames interpretados independentemente por médicos cegados, e com a curva construída utilizando a radiografia de tórax como padrão-ouro, o resultado foi: sensibilidade de 89,95% e especificidade de 19,05%.
Dezenove por cento. Uma especificidade de 19,05% significa que cerca de quatro em cada cinco achados positivos do ultrassom foram contabilizados como erro. Erro segundo quem? Segundo o instrumento que enxerga menos. Agora compare com o mesmo exame julgado por outro juiz. Num estudo com 110 pacientes sob ventilação mecânica, usando a tomografia como padrão de referência, para pneumotórax a ultrassonografia teve 100% de sensibilidade e 97% de especificidade — e a radiografia, o antigo juiz, teve 66,7% de sensibilidade.
O exame não mudou. O juiz mudou. Especificidade de 19% e de 97% para o mesmo método, na mesma doença, dependendo de quem corrigiu a prova. Este capítulo é sobre o fato de que toda acurácia é medida contra alguma coisa — e essa coisa também erra.
O mecanismo
Comece pela definição, porque ela contém a armadilha. Sensibilidade e especificidade são probabilidades condicionais ao estado de doença; suas estimativas em um estudo dependem do padrão de referência e podem ser enviesadas quando ele erra.
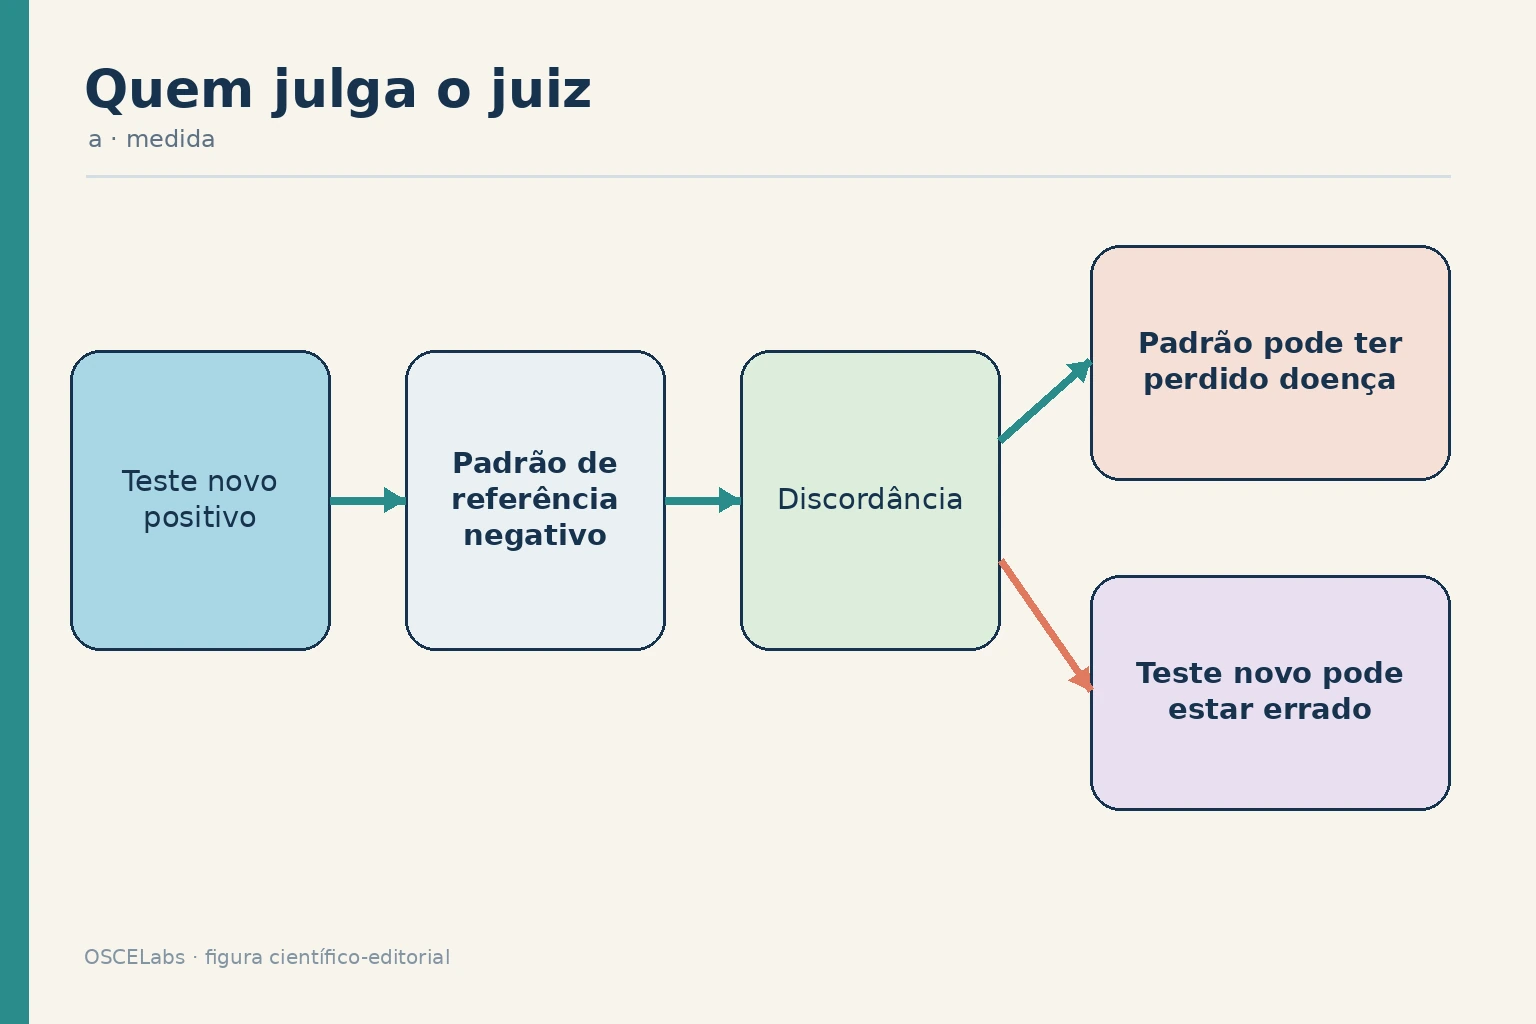
Não existe "acurácia" absoluta: existe concordância com um juiz. E o juiz é escolhido por quem desenha o estudo. Se o juiz fosse perfeito, tudo bem. Mas o padrão de referência é, quase sempre, outro teste — com seus próprios erros.
A literatura metodológica registra isso sem rodeios: o padrão-ouro imperfeito é uma questão comum em estudos de acurácia diagnóstica, e o padrão de referência para o estado de doença está sujeito A erro. Agora o ponto que inverte a intuição.
Quando o juiz erra, o erro dele não se distribui ao acaso: ele vira erro do teste, com sinal invertido. Imagine que o teste novo detecta uma lesão real que o padrão não consegue ver.
Pelo protocolo do estudo, o padrão disse "não há doença" e o teste disse "há". Esse acerto é registrado como falso-positivo. Portanto, um teste novo pode parecer menos específico quando detecta doença real que o padrão imperfeito perde; o efeito depende do padrão e do desenho.
Guarde a formulação, porque ela é a lição inteira: o teto de desempenho aparente de um teste é o desempenho do padrão que o julga. Um teste não pode parecer melhor do que o seu juiz — ele só pode parecer errado com mais frequência.
Agora a demonstração numérica lado a lado, porque ela é rara e limpa. Contra a radiografia como padrão-ouro, em crianças sob suporte respiratório: sensibilidade de 89,95% e especificidade de 19,05%. Contra a tomografia como padrão de referência, em adultos ventilados: para pneumotórax, sensibilidade de 100% e especificidade de 97%, com o desempenho global da ultrassonografia significativamente superior ao da radiografia.
E, no mesmo estudo, a radiografia — que no primeiro trabalho era o juiz — teve apenas 66,7% de sensibilidade para pneumotórax. Ou seja: o juiz do primeiro estudo erra um terço dos pneumotórax. E era ele quem definia o que era verdade.
Repare no detalhe fino do primeiro estudo: nenhum pneumotórax foi detectado na série. Numa população em suporte respiratório, isso diz mais sobre o instrumento de referência do que sobre as crianças. Agora a pergunta honesta: por que alguém usaria o juiz pior?
Porque o juiz melhor custa caro e faz dano. A literatura diz isso explicitamente: a radiografia de tórax e as provas de função pulmonar têm sensibilidade limitada, enquanto a tomografia de alta resolução, embora seja O padrão de referência, É limitada por custo E exposição À radiação.
Ou seja: a escolha do padrão é uma decisão de recursos e de risco — e essa decisão contamina o número que sai do estudo. Não é desonestidade. É um custo real sendo pago em unidades de acurácia aparente.
Mas é preciso dizer que foi pago. Agora o sintoma epidemiológico dessa contaminação. Quando cada estudo escolhe um juiz diferente, as faixas de desempenho explodem. Numa revisão sistemática com 36 estudos, a ultrassonografia pulmonar foi o método mais frequentemente avaliado, com sensibilidade de 70 A 100% E especificidade de 56 A 97%.
Uma especificidade que vai de 56 a 97% não descreve um teste: descreve um conjunto de comparações diferentes agrupadas sob o mesmo nome. A mesma revisão registra que apenas um estudo de tomografia de alta resolução foi identificado e que nenhum estudo avaliou volumes pulmonares — com risco de viés incerto em 15 dos 36 e a conclusão de que a estratégia diagnóstica ótima permanece incerta.
Quando a dispersão dos resultados é maior que a diferença entre testes, o que está variando não é o teste: é o desenho. Agora o que a matemática diz que se pode salvar, e ela é surpreendentemente precisa.
Se a acurácia do padrão imperfeito é conhecida ou estimável, e se vale o pressuposto de independência condicional, as curvas são identificáveis e podem ser estimadas. Mas, se a acurácia do padrão permanece desconhecida, as curvas são não identificáveis.
Não é que fiquem imprecisas: elas não podem ser recuperadas a partir dos dados, por princípio. E, ainda assim, algo sobrevive: o sinal da diferença entre duas áreas sob a curva continua identificável — o que permite testar a superioridade relativa entre dois testes.
Traduzindo para a cabeceira: você pode não conseguir dizer quão bom cada teste é, e ainda assim conseguir dizer qual dos dois É melhor. É uma lição de humildade produtiva: perde-se o valor absoluto e preserva-se a ordenação.
E note a consequência prática: perguntas do tipo "qual a sensibilidade deste exame?" podem ser irrespondíveis, enquanto "qual dos dois devo usar?" continua respondível. Agora a saída metodológica que a área desenvolveu. Em vez de eleger um juiz, trata-se a doença como variável não observada e estima-se o desempenho de todos os testes simultaneamente. É a análise de classe latente.
Num estudo com 100 dentes, em que doenças pulpares e periodontais se apresentam com achados sobrepostos, ela foi usada para estimar sensibilidade, especificidade, valores preditivos e prevalência na ausência de um padrão-ouro definitivo. Noutro, com 296 gestantes, um ensaio molecular foi comparado a microscopia e a teste de antígeno, com análise bayesiana de classe latente usada para estimar o desempenho na ausência de padrão de referência perfeito — num contexto em que as ferramentas disponíveis carecem de sensibilidade para infecções de baixa intensidade.
Repare no reconhecimento embutido: quando todos os testes disponíveis erram, eleger um deles como verdade é escolher qual erro será chamado de realidade. Mas a saída tem preço, e é preciso dizê-lo: a análise de classe latente exige suposições — tipicamente a independência condicional entre os testes dado o estado de doença.
Se dois testes erram pelos mesmos motivos, essa suposição falha. Troca-se, portanto, um pressuposto visível — o juiz escolhido — por um pressuposto invisível — a independência entre os erros. O ganho é real, mas não é gratuito, e um pressuposto invisível é mais perigoso que um declarado. A pergunta que fica: quem julgou este teste — e quem julga o juiz?
Sensibilidade e especificidade são probabilidades condicionais ao estado de doença no modelo conceitual; suas estimativas, porém, podem ser enviesadas quando o padrão de referência erra ou é aplicado de forma diferencial. Um achado real do teste novo que o padrão não detecta será contado como falso-positivo na tabela ingênua, mas isso não autoriza concluir que quanto melhor o teste, pior será sempre sua especificidade. Estudos devem explicitar o alvo clínico, a verificação, o cegamento e métodos para padrão imperfeito, incluindo consenso, seguimento ou modelos de classe latente quando defensáveis.
O que o mecanismo explica
Seis perguntas diante de uma sensibilidade publicada.
“Sensibilidade é propriedade do teste?”
Não: é concordância com um padrão de referência escolhido.
“O que acontece quando o teste é melhor que o juiz?”
Seus acertos onde o juiz não vê são contados como falso-positivos.
“Qual é o teto de desempenho aparente?”
O desempenho do próprio padrão que julga o teste.
“Por que se usa um padrão pior?”
O melhor é limitado por custo e exposição à radiação.
“O que sobrevive quando a acurácia do padrão é desconhecida?”
O sinal da diferença entre duas áreas sob a curva.
“Qual é o preço da análise de classe latente?”
Ela exige supor independência condicional entre os testes.
Como se orientar
- Procurar qual foi o padrão
- Toda acurácia publicada tem um juiz declarado.
- Avaliar o desempenho do próprio padrão
- Ele define o teto do que o teste pode aparentar.
- Desconfiar de especificidade muito baixa
- Pode indicar teste melhor que o juiz.
- Comparar estudos pelo juiz usado
- Faixas amplas costumam refletir juízes diferentes.
- Notar achados ausentes na série
- Zero detecções pode ser limitação do padrão.
- Preferir comparação direta entre dois testes
- A ordenação sobrevive mesmo com juiz imperfeito.
- Reconhecer análise de classe latente
- Ela é usada quando não há padrão definitivo.
- Perguntar pelos pressupostos do método
- Independência condicional pode não valer.
O raciocínio
Da definição de acurácia à pergunta sobre o juiz.
- 1
Definir acurácia como concordância
Sensibilidade e especificidade medem acordo com um padrão.
Erro comum: Tratar acurácia como propriedade intrínseca do teste.
- 2
Identificar quem escolheu o padrão
O juiz é definido no desenho do estudo.
Erro comum: Ler o número sem procurar o comparador.
- 3
Reconhecer o erro do padrão
O padrão de referência está sujeito a erro.
Erro comum: Assumir padrão-ouro como verdade.
- 4
Seguir o destino do acerto
Detectar o que o padrão não vê gera falso-positivo.
Erro comum: Interpretar falso-positivo como erro do teste novo.
- 5
Enunciar a regra do teto
O desempenho aparente é limitado pelo desempenho do juiz.
Erro comum: Esperar que um teste supere o padrão nos números.
- 6
Ler o resultado contra radiografia
Sensibilidade de 89,95% com especificidade de 19,05%.
Erro comum: Concluir que o exame é inespecífico.
- 7
Ler o resultado contra tomografia
Sensibilidade de 100% e especificidade de 97% para pneumotórax.
Erro comum: Comparar os dois estudos como se medissem a mesma coisa.
- 8
Avaliar o juiz do primeiro estudo
A radiografia teve 66,7% de sensibilidade para pneumotórax.
Erro comum: Manter o padrão como referência sem checar seu desempenho.
- 9
Notar o achado ausente
Nenhum pneumotórax detectado numa série sob suporte respiratório.
Erro comum: Ler ausência de detecção como ausência de doença.
- 10
Nomear a razão da escolha do padrão
O padrão melhor é limitado por custo e exposição à radiação.
Erro comum: Tratar a escolha do juiz como detalhe técnico neutro.
- 11
Ler a dispersão entre estudos
Sensibilidade de 70 a 100% e especificidade de 56 a 97% em 36 estudos.
Erro comum: Tomar a média das faixas como valor do teste.
- 12
Interpretar a dispersão como sinal
Variação maior que a diferença entre testes aponta o desenho.
Erro comum: Atribuir a variação apenas à população estudada.
- 13
Distinguir os dois cenários matemáticos
Acurácia do padrão conhecida contra desconhecida.
Erro comum: Assumir que sempre se pode estimar a curva verdadeira.
- 14
Reconhecer a não identificabilidade
Com padrão de acurácia desconhecida, as curvas não são recuperáveis.
Erro comum: Confundir imprecisão com impossibilidade de identificação.
- 15
Aproveitar o que sobrevive
O sinal da diferença entre áreas permanece identificável.
Erro comum: Descartar a comparação por não haver padrão perfeito.
- 16
Reformular a pergunta clínica
Trocar quanto vale este exame por qual dos dois é melhor.
Erro comum: Insistir numa pergunta irrespondível com os dados existentes.
- 17
Apresentar a classe latente
A doença é tratada como variável não observada.
Erro comum: Eleger um teste como verdade quando todos erram.
- 18
Ler os exemplos de aplicação
Cem dentes com achados sobrepostos e 296 gestantes com testes pouco sensíveis.
Erro comum: Considerar o método restrito a exercícios teóricos.
- 19
Explicitar o pressuposto do método
Independência condicional entre os testes dado o estado de doença.
Erro comum: Adotar a solução sem declarar sua suposição.
- 20
Fechar pela pergunta do juiz
Perguntar quem julgou o teste e quem julga o juiz.
Erro comum: Citar acurácia sem nomear o padrão de referência.
Esperado e alterado
- Acurácia relatada junto com o padrão de referência utilizado.
- Padrão de referência com desempenho conhecido e declarado.
- Comparação direta entre dois testes no mesmo estudo.
- Método de classe latente com pressupostos explicitados.
- Especificidade de 19,05% contra radiografia
- Compatível com teste que detecta o que o padrão não enxerga.
- Especificidade de 97% contra tomografia
- Mesmo exame com juiz melhor, revelando o efeito do padrão.
- Padrão com 66,7% de sensibilidade para pneumotórax
- Juiz que erra um terço dos casos define o que é verdade.
- Nenhum pneumotórax detectado em série de terapia intensiva
- Possível limitação do instrumento de referência.
- Sensibilidade de 70 a 100% entre estudos
- Dispersão compatível com padrões de referência heterogêneos.
- Especificidade de 56 a 97% entre estudos
- Faixa que descreve comparações diferentes, não um único teste.
- Acurácia publicada sem menção ao padrão
- Número ininterpretável, por falta do comparador.
- Estimativa por classe latente sem declaração de pressupostos
- Troca de um pressuposto visível por um invisível.
Por que isso importa
Sensibilidade e especificidade são probabilidades condicionais ao estado de doença; as estimativas observadas dependem do padrão de referência escolhido e podem ser enviesadas quando ele erra. A literatura metodológica registra que o padrão-ouro imperfeito é questão comum e que o padrão para o estado de doença está sujeito A erro.
E o erro do juiz não se distribui ao acaso: ele vira erro do teste, com sinal invertido. Quando o teste novo detecta uma lesão real que o padrão não vê, esse acerto é registrado como falso-positivo.
Portanto, um teste novo pode parecer menos específico quando detecta doença real perdida pelo padrão; isso não é uma lei universal. O teto de desempenho aparente de um teste é o desempenho do padrão que o julga — um teste não pode parecer melhor que o seu juiz, só pode parecer errado com mais frequência.
A demonstração é limpa: contra a radiografia como padrão-ouro, em 220 ultrassonografias de 117 pacientes com interpretação independente por médicos cegados, a ultrassonografia teve sensibilidade de 89,95% e especificidade de 19,05% — ou seja, cerca de quatro em cada cinco achados positivos foram contabilizados como erro, segundo o instrumento que enxerga menos.
Contra a tomografia como referência, em 110 pacientes ventilados, a mesma modalidade teve, para pneumotórax, 100% de sensibilidade e 97% de especificidade, com desempenho global significativamente superior ao da radiografia — que, nesse estudo, alcançou apenas 66,7% de sensibilidade.
O exame não mudou. O juiz mudou. E vale notar que, no primeiro estudo, nenhum pneumotórax foi detectado numa população em suporte respiratório — o que diz mais sobre o instrumento de referência do que sobre as crianças.
Por que usar o juiz pior? Porque o melhor custa caro e faz dano: a literatura registra que radiografia e provas de função pulmonar têm sensibilidade limitada, enquanto a tomografia de alta resolução, embora seja O padrão de referência, É limitada por custo E exposição À radiação. A escolha do padrão é decisão de recursos e de risco — e contamina o número que sai. Não é desonestidade: é um custo pago em unidades de acurácia aparente. Mas precisa ser declarado.
O sintoma epidemiológico é a dispersão: numa revisão com 36 estudos, a ultrassonografia pulmonar mostrou sensibilidade de 70 A 100% e especificidade de 56 A 97%, com apenas um estudo de tomografia de alta resolução identificado, nenhum avaliando volumes pulmonares, risco de viés incerto em 15 dos 36, e a conclusão de que a estratégia ótima permanece incerta.
Uma especificidade que vai de 56 a 97% não descreve um teste: descreve comparações diferentes agrupadas sob o mesmo nome. Quando a dispersão é maior que a diferença entre testes, o que varia é o desenho.
A matemática é precisa sobre o que se salva. Se a acurácia do padrão é conhecida ou estimável e vale independência condicional, as curvas são identificáveis. Se ela permanece desconhecida, as curvas são não identificáveis — não imprecisas: irrecuperáveis a partir dos dados, por princípio.
E ainda assim algo sobrevive: o sinal da diferença entre duas áreas sob a curva continua identificável, permitindo testar superioridade relativa. Pode-se não saber quão bom cada teste é e ainda assim saber qual dos dois É melhor — perde-se o valor absoluto e preserva-se a ordenação. Na prática: "qual a sensibilidade deste exame?" pode ser irrespondível, enquanto "qual dos dois devo usar?" continua respondível.
A saída metodológica é tratar a doença como variável não observada e estimar o desempenho de todos os testes simultaneamente — a análise de classe latente. Ela foi usada em 100 dentes com achados clínicos e radiográficos sobrepostos, para estimar sensibilidade, especificidade, valores preditivos e prevalência na ausência de padrão-ouro definitivo; e em 296 gestantes, comparando ensaio molecular a microscopia e teste de antígeno, num contexto em que as ferramentas disponíveis carecem de sensibilidade.
Quando todos os testes disponíveis erram, eleger um deles como verdade é escolher qual erro será chamado de realidade. Mas a saída tem preço: a análise de classe latente exige supor independência condicional entre os testes dado o estado de doença — e, se dois testes erram pelos mesmos motivos, a suposição falha. Troca-se um pressuposto visível, o juiz escolhido, por um invisível, a independência entre os erros — e um pressuposto invisível é mais perigoso que um declarado. Quem julgou este teste — e quem julga o juiz?
| Sinal | Medida | Valor | Fonte |
|---|---|---|---|
| Desempenho medido contra um padrão que enxerga menos | Estudo transversal de acurácia diagnóstica com leitura cegada (E3, descritivo humano). | Em 195 ultrassonografias pulmonares de 117 crianças em terapia intensiva, o exame teve sensibilidade de 89,95% e especificidade de apenas 19,05% tendo a radiografia como padrão-ouro: a especificidade baixa reflete achados que o padrão de comparação não enxerga, não erro do ultrassom. | Diagnostic accuracy of lung ultrasound in children with respiratory pathology admitted in a pediatric intensive care unit of a low-resource setting: a single-center experience. Crit Care Sci. 2026. doi:10.62675/2965-2774.20260146 |
| O mesmo exame julgado por um padrão melhor | Estudo observacional prospectivo com padrão de referência tomográfico (E3, descritivo humano). | Em 110 pacientes em ventilação mecânica avaliados com a tomografia como referência, a ultrassonografia detectou pneumotórax com 100% de sensibilidade e 97% de especificidade, contra 66,7% de sensibilidade da radiografia: trocar o padrão de comparação muda o desempenho medido. | Comparative Analysis of Lung Ultrasound, Computed Tomography, and X-ray in the Diagnosis of Common Pathologies among Critically Ill Mechanically Ventilated Patients - A Prospective Observational Study. Indian J Crit Care Med. 2025. doi:10.5005/jp-journals-10071-25061 |
| O que é identificável com padrão imperfeito | Artigo metodológico com demonstração teórica e estudos de simulação (E7, índice de síntese metodológica). | Em artigo metodológico sobre acurácia com padrão-ouro imperfeito, as curvas ROC só são identificáveis quando a acurácia do próprio padrão é conhecida; sem isso, resta estimar apenas o sinal da diferença entre 2 áreas sob a curva: dá para dizer qual teste é melhor, não quanto. | Nonparametric receiver operating characteristic curve analysis with an imperfect gold standard. Biometrics. 2024. doi:10.1093/biomtc/ujae063 |
| Dispersão de desempenho entre estudos | Revisão sistemática com avaliação formal de risco de viés (E7, índice de síntese). | Em revisão sistemática de 36 estudos sobre doença pulmonar intersticial na artrite reumatoide, a ultrassonografia pulmonar mostrou sensibilidade de 70 a 100% e especificidade de 56 a 97%: a amplitude entre estudos vem de populações e padrões de referência diferentes. | Diagnostic methods of rheumatoid arthritis-associated interstitial lung disease: a systematic review. Rheumatol Int. 2026. doi:10.1007/s00296-026-06268-0 |
| Razão declarada para não usar o melhor padrão | Estudo observacional prospectivo com padrão de referência tomográfico (E3, descritivo humano). | Em 86 pacientes com artrite reumatoide e sintomas respiratórios avaliados por ultrassonografia e tomografia de alta resolução, os autores usam a tomografia como referência mas apontam custo e radiação como limite ao uso rotineiro: o melhor padrão nem sempre é o aplicável. | Diagnostic value of lung ultrasound in interstitial lung disease associated with rheumatoid arthritis: Correlation with HRCT and differentiation of ILD subtypes. Rheumatol Immunol Res. 2026. doi:10.1515/rir-2026-0012 |
| Estimativa sem padrão-ouro definitivo | Estudos transversais de acurácia com modelagem de classe latente (E3 combinado a E7, descritivo humano com síntese metodológica). | Em 100 dentes com lesões endodôntico-periodontais e, de modo análogo, em 296 gestantes testadas para infecção, sensibilidade, especificidade e prevalência tiveram de ser estimadas por modelagem na ausência de padrão-ouro definitivo: sem referência, o desempenho é inferido, não medido. | Diagnostic Accuracy of Pulp Sensibility Tests and Radiographic Findings for Endodontic-Periodontal Lesions. Cureus. 2026. doi:10.7759/cureus.111365 |
Esquemas e tabelas
O mesmo exame sob juízes diferentes.
| Padrão de referência | Sensibilidade | Especificidade |
|---|---|---|
| Radiografia de tórax, geral | 89,95% | 19,05% |
| Tomografia, pneumotórax | 100% | 97% |
| Radiografia, pneumotórax | 66,7% | Não informada |
| Leitura | O exame não mudou | O juiz mudou |
O que é identificável
| Situação do padrão | O que se pode estimar |
|---|---|
| Acurácia conhecida ou estimável | As curvas são identificáveis |
| Acurácia desconhecida | As curvas não são identificáveis |
| Em ambos os casos | O sinal da diferença entre áreas |
Dispersão numa revisão com 36 estudos
| Métrica | Faixa |
|---|---|
| Sensibilidade | 70 a 100% |
| Especificidade | 56 a 97% |
| Estudos com tomografia de alta resolução | Apenas um |
| Risco de viés incerto | 15 de 36 |
- A escolha do padrão é limitada por custo e exposição à radiação.
- A análise de classe latente supõe independência condicional entre os testes.
Onde se erra
- Tratar acurácia como intrínseca
- Ela mede concordância com um padrão escolhido.
- Ler o número sem o comparador
- Sem o juiz, a acurácia é ininterpretável.
- Assumir padrão-ouro como verdade
- Ele também está sujeito a erro.
- Ler falso-positivo como erro do teste
- Pode ser acerto que o padrão não enxergou.
- Esperar que o teste supere o juiz
- O teto aparente é o desempenho do padrão.
- Concluir inespecificidade por 19,05%
- O mesmo exame teve 97% contra outro padrão.
- Comparar estudos com juízes diferentes
- Eles não estão medindo a mesma coisa.
- Ler ausência de detecção como ausência de doença
- Nenhum pneumotórax foi detectado pelo padrão na série.
- Tratar a escolha do juiz como neutra
- Ela envolve custo e exposição à radiação.
- Tomar a média das faixas
- A dispersão reflete desenhos diferentes.
- Assumir que a curva sempre é estimável
- Com padrão de acurácia desconhecida ela não é identificável.
- Descartar a comparação entre testes
- O sinal da diferença permanece identificável.
- Eleger um teste como verdade
- Quando todos erram, isso escolhe qual erro vira realidade.
- Adotar classe latente sem declarar pressupostos
- Ela exige independência condicional entre os testes.
Roteiro do raciocínio
Da definição de acurácia à pergunta sobre o juiz.
- 01Definir acurácia como concordância com um padrão
- 02Identificar quem escolheu o padrão
- 03Reconhecer que o padrão erra
- 04Seguir o destino do acerto não visto pelo juiz
- 05Enunciar a regra do teto de desempenho
- 06Ler o resultado contra a radiografia
- 07Ler o resultado contra a tomografia
- 08Avaliar o desempenho do próprio juiz
- 09Notar o achado ausente na série
- 10Nomear a razão da escolha do padrão
- 11Ler a dispersão entre estudos
- 12Interpretar a dispersão como sinal de desenho
- 13Distinguir padrão de acurácia conhecida e desconhecida
- 14Reconhecer a não identificabilidade das curvas
- 15Aproveitar o sinal da diferença entre áreas
- 16Reformular a pergunta clínica
- 17Apresentar a análise de classe latente
- 18Explicitar o pressuposto de independência condicional
Teste-se
Leve para o paciente
Menina de 7 anos é trazida pela família e a primeira coisa que você ouve é: "Doutor, a Helena está com muita dor de garganta e febre alta há três dias, e hoje ela quase não conseguiu comer nem beber água." Agora é sua vez: conduza a anamnese, examine e monte o seu raciocínio.
Revisão espaçada
Acurácia é propriedade do teste? O que acontece quando o teste é melhor que o juiz? Por que se usa o padrão pior?
Explique por que o teto de desempenho aparente é o desempenho do padrão — e o que continua identificável quando a acurácia do padrão é desconhecida.