
Raciocínio Clínico e Exames › Ler um estudo sem ser enganado
O valor de p responde uma pergunta que ninguém fez
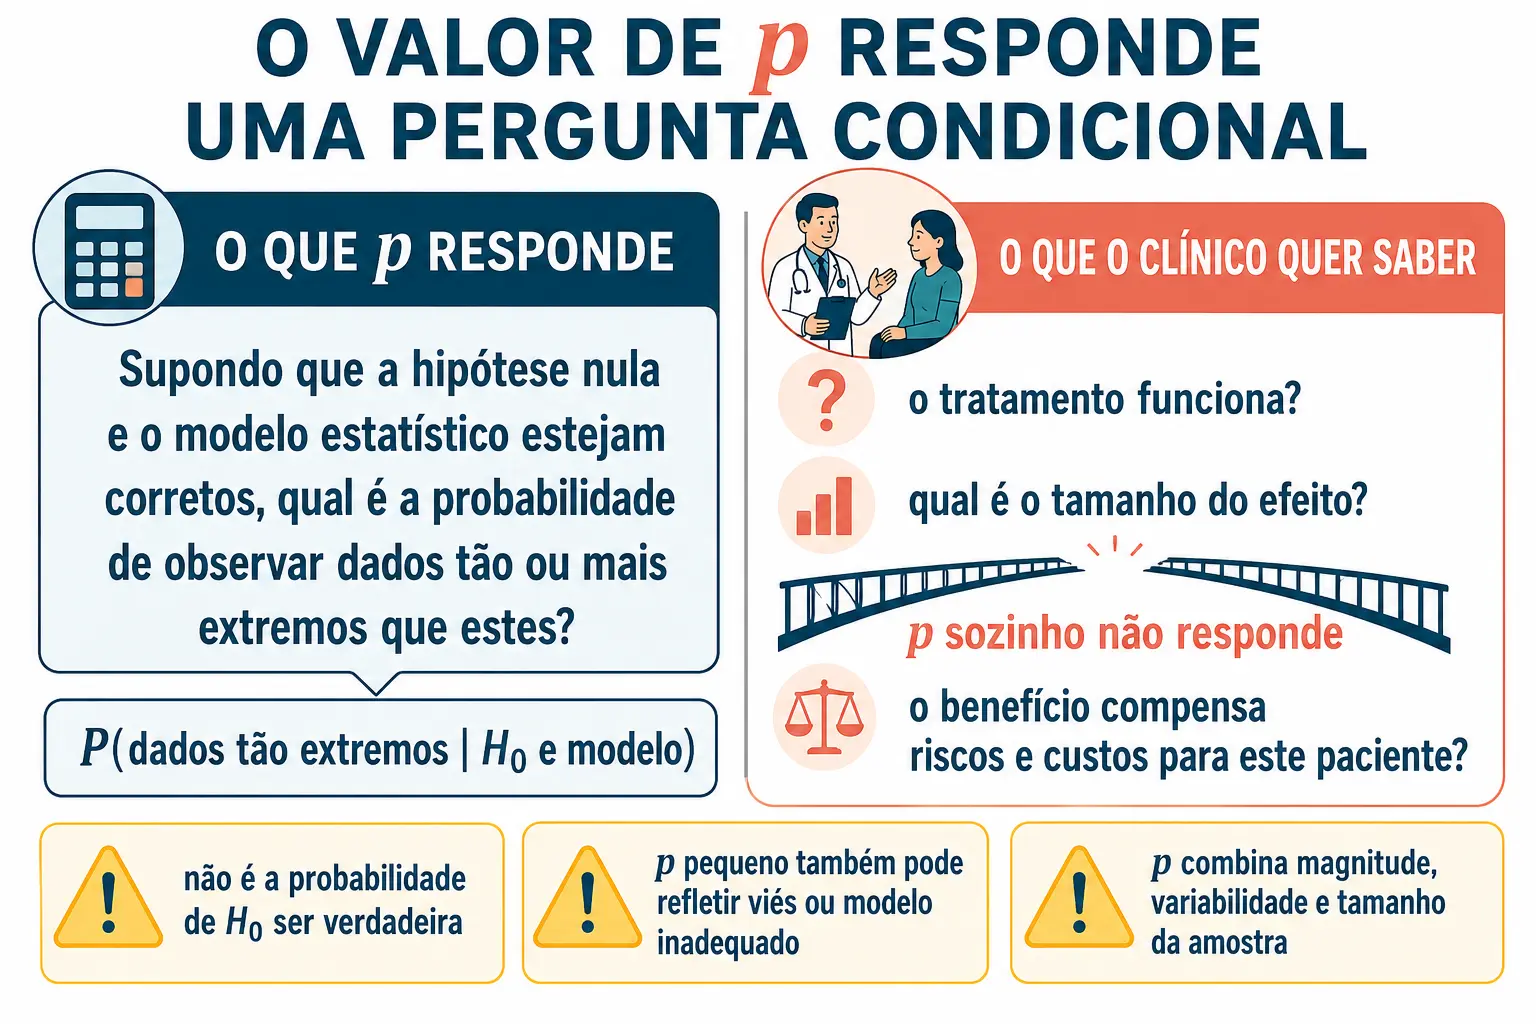
O valor de p mede compatibilidade dos dados com um modelo nulo; não mede benefício, verdade nem probabilidade da hipótese.
O caso
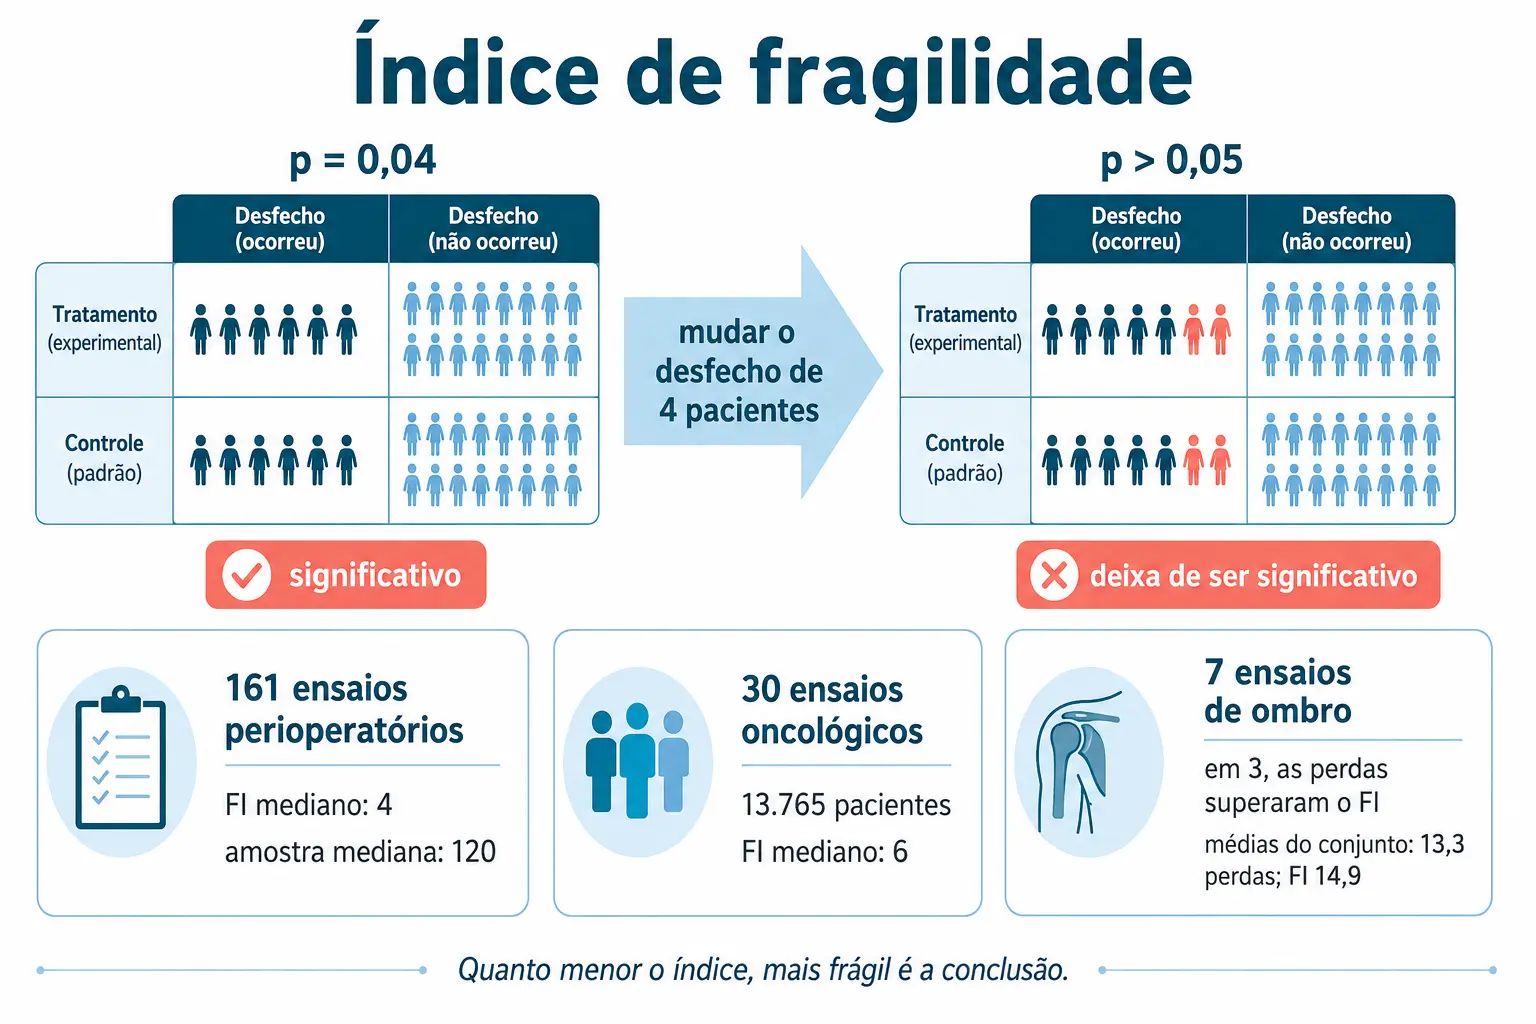
Caso 1. Um ensaio comparou duas condutas e encontrou diferença com valor de p igual a 0,04. O resultado entrou numa diretriz e mudou a rotina de muitos serviços. Anos depois, alguém calculou quantos pacientes precisariam ter tido desfecho diferente para que aquele p ultrapassasse 0,05: quatro. Quatro pacientes, num estudo com pouco mais de cem participantes.
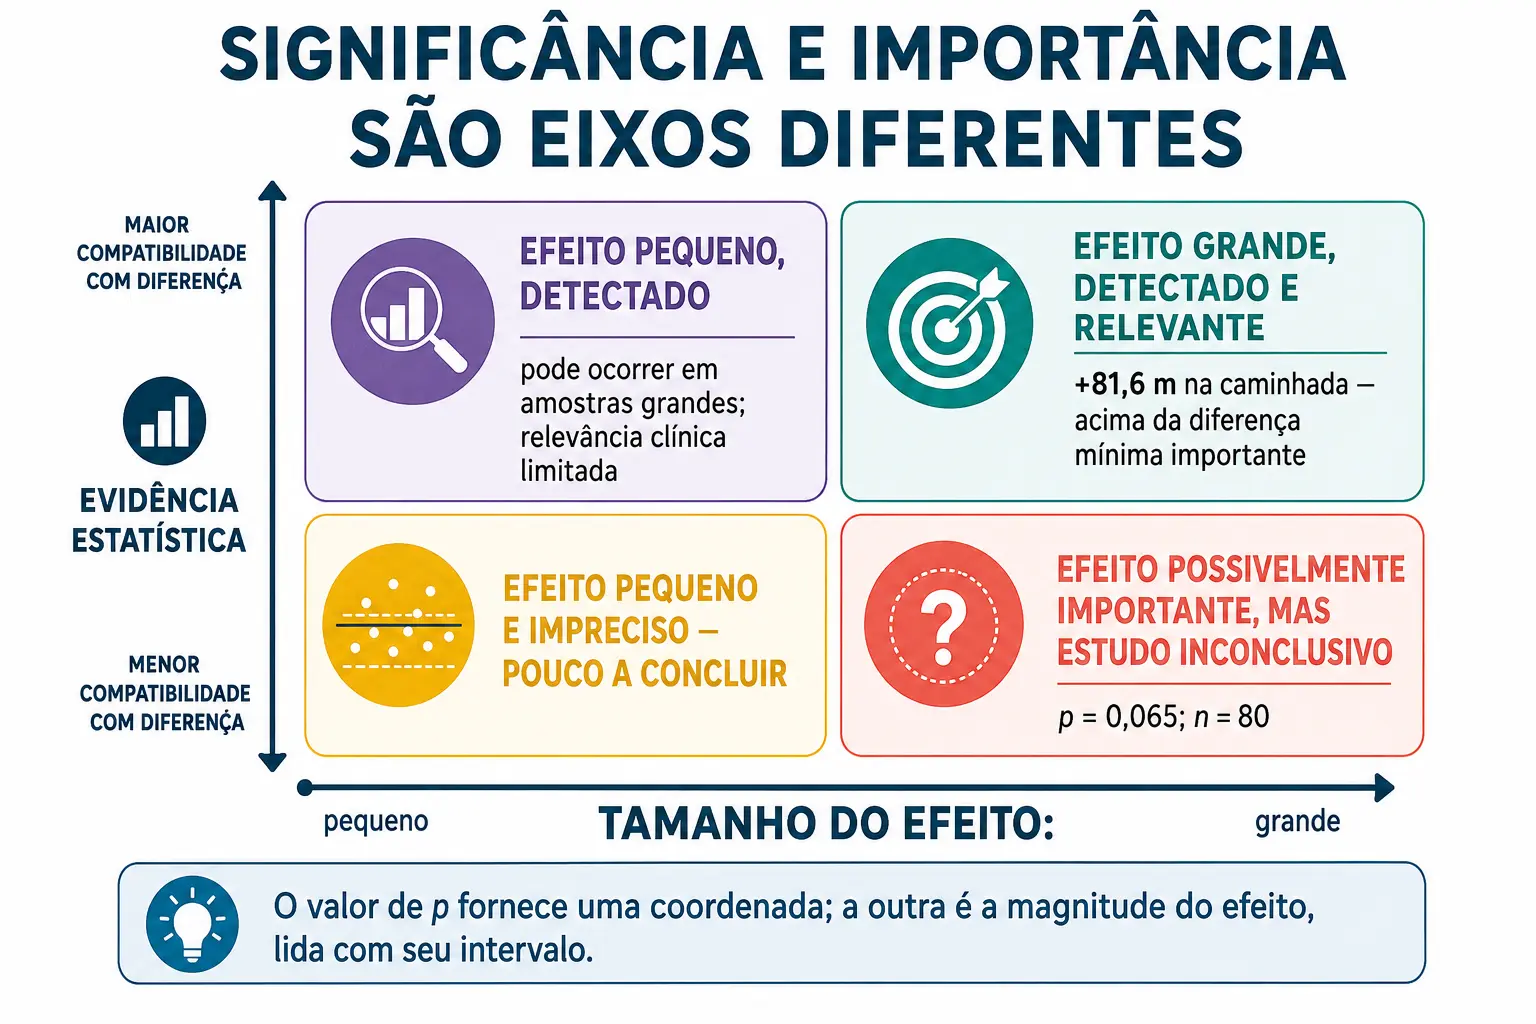
Caso 2. Outro ensaio testou uma intervenção e concluiu que ela não funcionou, porque o valor de p foi 0,065. Olhando a tabela com calma, a diferença entre os grupos era grande e clinicamente relevante — só que o estudo tinha oitenta participantes e não conseguiu estreitar a estimativa o suficiente para cruzar a linha convencional.
Os dois resultados foram comunicados pelo mesmo par de palavras: o primeiro "deu significativo", o segundo "não deu". Essas duas expressões carregam mais autoridade do que qualquer número no artigo, e é justamente essa autoridade que este capítulo desmonta.
Pare aqui e faça as perguntas que um aluno de primeiro ano tem todo o direito de fazer:
O modelo mental
Um p pequeno não informa a probabilidade de a hipótese nula ser verdadeira nem a importância clínica do efeito. Tamanho amostral, escolhas analíticas, multiplicidade e viés alteram sua interpretação. Um limiar rígido transforma evidência contínua em rótulo.
Em cada etapa, separe descrição, inferência e decisão. Essa distinção torna visível onde a evidência termina, onde começa o julgamento e qual dado exigiria revisão.
Comece pela definição, escrita com todas as condições que costumam ser omitidas. O valor de p é a probabilidade de obter um resultado tão extremo quanto o observado, ou mais extremo, supondo que a hipótese nula seja verdadeira e que todas as demais suposições do estudo — desenho, medida, ausência de viés, modelo estatístico — estejam corretas.
Três consequências saem direto dessa frase. Primeira: o p é uma probabilidade sobre os dados, e não sobre a hipótese. Ele não diz a chance de o tratamento funcionar, nem a chance de a conclusão estar errada. Segunda: o p depende de tudo o que está no estudo, não apenas do acaso — um p pequeno pode nascer de viés, e não de efeito. Terceira: como a conta parte da suposição de que não existe diferença, o p nunca é evidência direta a favor de uma hipótese; ele mede o desconforto dos dados com a hipótese de nada acontecer.
E existe uma quarta, a mais prática de todas: o p mistura duas coisas que a clínica precisa separar — o tamanho do efeito e a quantidade de informação. Um efeito minúsculo, medido em cem mil pessoas, produz p microscópico. Um efeito enorme, medido em vinte pessoas, produz p desconfortavelmente grande. O p sozinho não distingue as duas situações.
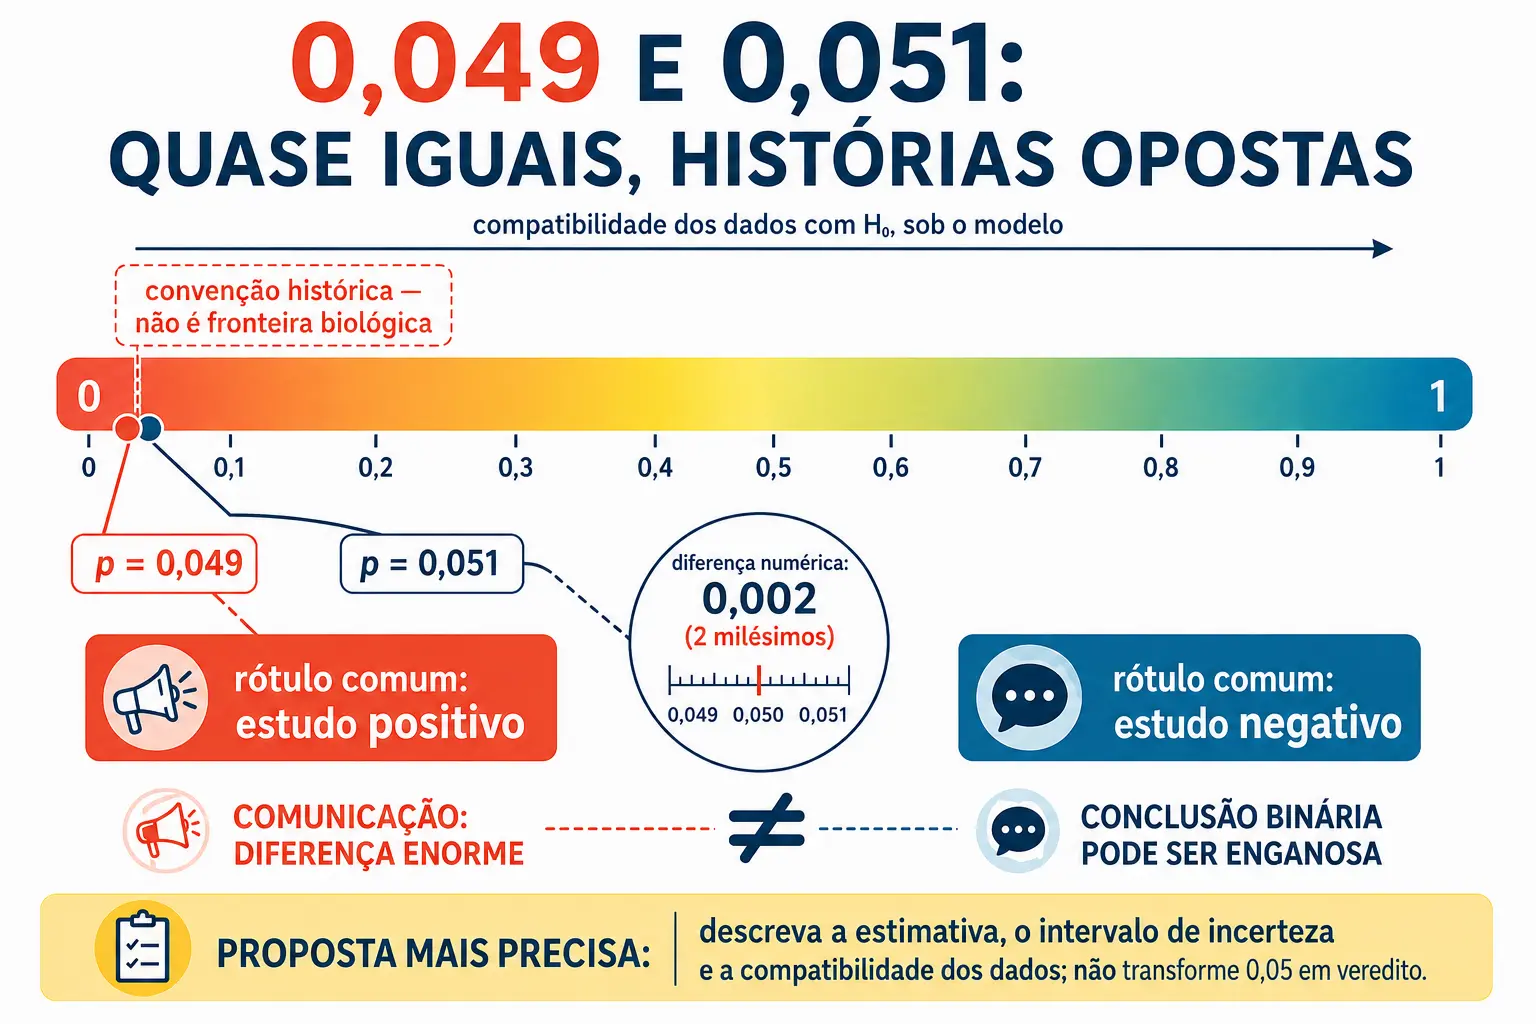
Agora o limiar. O número 0,05 não tem origem na biologia nem na clínica: é uma convenção adotada por conveniência histórica e mantida por hábito. E a convenção faz um estrago característico — transforma uma medida contínua em duas caixas. Um estudo com p igual a 0,049 e outro com p igual a 0,051 descrevem praticamente a mesma compatibilidade com o acaso, e são comunicados como se um tivesse descoberto algo e o outro nada.
É por isso que existe uma proposta explícita, em periódicos de metodologia, para trocar a linguagem: falar em divergência estatística no lugar de significância, porque significância sugere importância, e em intervalo de incerteza no lugar de intervalo de confiança, porque confiança sugere certeza. A mesma proposta recomenda interpretar o p de forma contínua, o que reduziria o pensamento binário e a manipulação de análises em busca do número mágico.
Há uma forma elegante de medir o quanto um resultado depende dessa linha: o índice de fragilidade. Ele conta quantos pacientes precisariam ter tido desfecho diferente para que a conclusão estatística mudasse de lado. É uma pergunta simples, e as respostas costumam assustar.
A pergunta central
Uma pergunta explícita delimita o que o dado pode e não pode decidir.
“Qual hipótese e modelo geraram este p, qual é o tamanho do efeito e quantas análises foram tentadas?”
Um p pequeno não informa a probabilidade de a hipótese nula ser verdadeira nem a importância clínica do efeito. Tamanho amostral, escolhas analíticas, multiplicidade e viés alteram sua interpretação. Um limiar rígido transforma evidência contínua em rótulo.
“O que o valor de p mede?”
Compatibilidade dos dados com a hipótese de nenhum efeito.
“Ele diz a chance de a conclusão estar errada?”
Não: é probabilidade sobre dados, não sobre hipóteses.
“Por que 0,05?”
Convenção histórica, sem origem biológica ou clínica.
Aplicação passo a passo
Reconstrua a pergunta e o método antes de ler o resultado. Depois integre efeito, incerteza, viés e aplicabilidade à decisão.
- 1
Recusar as duas palavras mágicas
Deu significativo e não deu escondem tudo o que importa.
Erro comum: Aceitar o rótulo binário como resumo do estudo.
- 2
Separar tamanho de informação
Efeito minúsculo em amostra enorme dá p microscópico.
Erro comum: Confundir precisão da estimativa com relevância clínica.
- 3
Comparar 0,049 com 0,051
Compatibilidade quase idêntica, comunicação oposta.
Erro comum: Publicar ou ler os dois como achados de naturezas distintas.
- 4
Olhar também o índice reverso
Quantos faltaram para o resultado virar significativo.
Erro comum: Ler estudo não significativo como demonstração de ausência.
- 5
Comparar com a diferença mínima importante
Mais 81,6 metros ultrapassou o mínimo perceptível.
Erro comum: Chamar de benefício qualquer diferença estatisticamente detectada.
- 6
Checar registro prévio do desfecho principal
Apenas 44% dos ensaios definiam um único primário.
Erro comum: Ignorar a liberdade de escolha do autor depois dos dados.
- 7
Emparelhar p e tamanho do efeito sempre
É a falha sutil que persiste até em bons periódicos.
Erro comum: Apresentar o p isolado em apresentação de caso ou aula.
- 8
Fechar pela pergunta de cabeceira
Qual o tamanho, qual a incerteza e quantos virariam isso?
Erro comum: Encerrar a leitura no valor de p.
Exemplo resolvido
Volte ao caso e aplique o modelo sem pular da seta do laudo para a conclusão. O ponto de controle é: Qual hipótese e modelo geraram este p, qual é o tamanho do efeito e quantas análises foram tentadas?
| Pergunta do caso | Peça que responde | Resposta em uma linha |
|---|---|---|
| O que o p mede? | Definição condicional | Compatibilidade dos dados com a hipótese de nenhum efeito |
| Significativo é importante? | Tamanho do efeito | Não: o p mistura magnitude com quantidade de informação |
| Por que 0,05? | Convenção | Limiar histórico, sem fundamento biológico |
| Quão firme é este resultado? | Índice de fragilidade | Mediana de 4 pacientes em ensaios que sustentam diretrizes |
| Não significativo é ausência? | Indecisão | É o estudo dizendo que não conseguiu decidir |
O que o valor de p é e o que ele não é
| Afirmação | Correta ou incorreta |
|---|---|
| Probabilidade de os dados serem tão extremos supondo nenhum efeito | Correta |
| Probabilidade de a hipótese nula ser verdadeira | Incorreta |
| Probabilidade de o resultado ter ocorrido por acaso | Incorreta |
| Medida do tamanho do efeito observado | Incorreta |
| Medida da importância clínica do achado | Incorreta |
| Número que depende também do viés e do desenho do estudo | Correta |
- Índice de fragilidade menor que o número de perdas de seguimento significa que a conclusão do estudo depende do desfecho de pacientes que ninguém conseguiu avaliar.
- A diferença mínima clinicamente importante é a régua que falta ao valor de p: ela informa se a mudança observada é do tamanho que o paciente percebe.
Limites e armadilhas
- Ler o p como probabilidade da hipótese
- Ele é probabilidade sobre dados, condicionada à hipótese nula.
- Tratar p pequeno como prova de efeito
- Viés e desenho frouxo também produzem valores pequenos.
- Confundir significativo com importante
- Amostra enorme torna detectável o irrelevante.
- Tratar 0,05 como fronteira da natureza
- É convenção histórica sobre uma medida contínua.
- Chamar de negativo o estudo com p limítrofe
- Indecisão não é demonstração de ausência.
- Ignorar a fragilidade do resultado
- A mediana em diretrizes perioperatórias é de quatro pacientes.
Regra prática para o atendimento
Feche o raciocínio em voz alta e deixe um plano que outra pessoa consiga revisar.
- 01Leia valor de p junto do efeito, intervalo, desenho, multiplicidade e plausibilidade; não use 0,05 como fronteira de verdade.
- 02Recusar o resumo binário do resultado
- 03Reconhecer a arbitrariedade do limiar
- 04Procurar o tamanho do efeito na tabela
- 05Trocar significância por divergência ao comunicar
- 06Perguntar quantos pacientes virariam a conclusão
Questões (10)
Ponte para o atendimento
No caso vinculado, transforme a dúvida em população, intervenção ou exposição, comparação, desfecho e tempo. Identifique o desenho, reconstrua o risco basal e apresente efeito absoluto, relativo e intervalo; depois localize o principal mecanismo de viés e teste a aplicabilidade.
Conclua dizendo quanto a evidência muda a decisão e qual incerteza ainda precisa ser compartilhada.
Revisão espaçada
Qual é a definição completa do valor de p, com todas as suposições? Por que um efeito irrelevante pode ter p microscópico e um efeito grande pode ter p limítrofe? O que mede o índice de fragilidade e qual foi sua mediana em ensaios que sustentam diretrizes?
Explique os dois casos de abertura por inteiro: por que um resultado com p igual a 0,04 e índice de fragilidade 4 merece confirmação antes de virar rotina, e por que um resultado com p igual a 0,065 e efeito grande não demonstra ausência de efeito. Inclua na resposta o papel da diferença mínima clinicamente importante.